Microsoft liet 1.024 coding agents werken zonder baas. 128 keer zoveel agents leverde 9,5 punten op

By Surya Pratap
29 september 2026
9 min read
AI & Technology

29 september 2026
9 min read
 Meer agents, vooral snellerHover to explore
De gebruikelijke manier om veel coding agents te draaien, is er één de leiding te geven: een planner verdeelt het werk en deelt het uit. Die planner wordt de bottleneck zodra er meer werkers zijn dan hij kan bijhouden. Een artikel van Microsoft Research van vorige week schrapt die planner helemaal en schaalt het resultaat op tot 1.024 agents. Het ontwerp is het bestuderen waard. De koppen verdienen een zorgvuldige lezing.
Alles hieronder komt uit 'Agensh: Scaling Organizational Intelligence to 1,024 Agents' van Zhihao Zhan, Ting Song, Li Dong, Shaohan Huang, Jianxun Lian, Yan Xia en Furu Wei van Microsoft Research, op 22 september 2026 op arXiv gezet. Het is een preprint en is niet peer-reviewed. De interpretatie vanaf sectie 3 is van mij.
ProgramBench geeft een agent een gecompileerd programma en vraagt hem de software vanaf nul na te bouwen — een complete codebase die compileert en zich hetzelfde gedraagt — binnen zes uur en zonder internettoegang. De score is het aandeel verborgen tests dat het nagebouwde programma doorstaat.
Agensh is getest op de vijf zwaarste van de 200 taken in ProgramBench, gekozen op hoe slecht huidige modellen erop presteren. Ze beslaan multimediaverwerking, moleculaire simulatie, documentconversie, taalinterpretatie en code-indexering. Alle werkers gebruikten hetzelfde model, GPT-5.6-sol met hoge redeneerinzet.
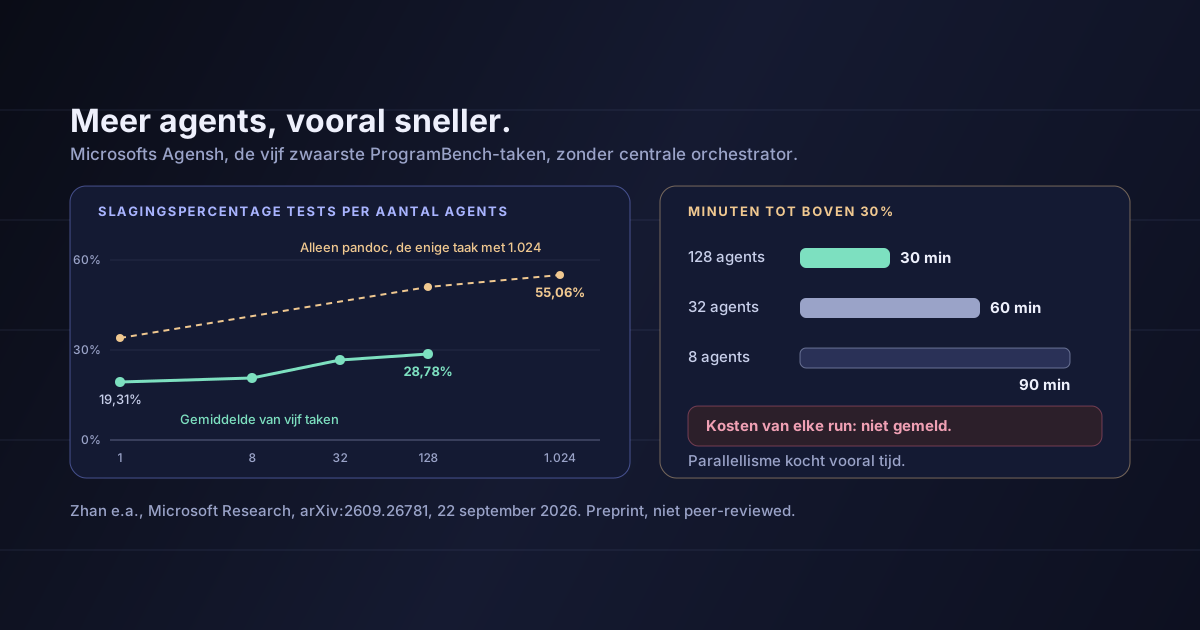
Gemiddeld slagingspercentage van de tests over de vijf taken:
| Agents | Gemiddeld slagingspercentage | Verschil met vorige rij |
|---|---|---|
| 1 | 19,31% | — |
| 8 | 20,68% | +1,37 punt |
| 32 | 26,52% | +5,84 punten |
| 128 | 28,78% | +2,26 punten |
Van 1 naar 128 agents is dat zo'n 9,5 punten, wat de auteurs omschrijven als een relatieve verbetering van ongeveer 49%.
Maar één taak, de documentconverter pandoc, is gedraaid met de volle 1.024 agents:
Acht keer zoveel agents als in de run met 128 leverden zo'n 4 punten op, op de enige taak waar het is geprobeerd.
De curve gaat omhoog. Langzaam, en elke stap kost veel meer agents dan de vorige.
Het praktischste getal in het artikel is niet de eindscore. Het is hoe snel elke configuratie iets bruikbaars bereikte. De auteurs melden dat 128 agents een slagingspercentage van 30% haalden na 30 minuten. Met 32 agents duurde dat 60 minuten, met 8 agents 90.
Dat is wat parallellisme betrouwbaar oplevert: een bepaald niveau eerder halen. Het plafond schoof ook op, maar bescheiden. De tijd tot een werkbaar niveau schoof flink op.
Voor een founder maakt dat verschil uit. Betaal je voor een snellere doorlooptijd van werk waarop je anders ook had kunnen wachten, dan koop je met meer agents latency, en dat kun je beprijzen. Hoop je dat meer agents problemen oplossen die één agent niet oplost, dan laat dit artikel zien dat dat effect bestaat, maar klein is in verhouding tot het aantal toegevoegde agents.
Het ontwerp is het deel dat je moet overnemen, en het is eenvoudiger dan de schaal doet vermoeden. Er zijn drie gedeelde onderdelen:
Een gedeelde werkruimte. Een git-server. Elke werker heeft een eigen checkout en branch en merget naar een main branch. Git legt vast wie wat veranderde en detecteert mergeconflicten. Loopt een merge vast, dan haalt de werker het nieuwste werk van anderen op, lost het conflict op en merget opnieuw.
Een berichteninterface. Gedeelde kanalen per taak plus directe berichten, asynchroon bezorgd en met bewaarde geschiedenis, zodat werkers kunnen afspreken wie wat oppakt en afhankelijkheden kunnen ontwarren.
Een gedeelde context. Een append-only log met getypeerde regels — OBSERVED, FACT, FAIL, CLAIM, PATCH_SUMMARY — waarin elke werker kan zoeken. Voordat hij begint, plaatst een werker een CLAIM met de afbakening van wat hij oppakt.
Elke werker doorloopt dezelfde lus: de gedeelde context lezen, een stuk werk claimen, het uitvoeren, het toetsen aan de acceptatiecriteria van dat stuk, mergen en publiceren wat er veranderde en waarom. Er zijn geen locks. Overlap wordt opgelost met claims en overleg.
Eén detail laat zien waar de echte kosten van coördinatie zitten. Om onenigheid over wie wat oppakt te beperken, startten de auteurs niet alle agents tegelijk. Ze startten er elke 30 seconden één in het eerste uur, en daarna elke 3 seconden één. Zelfs met een ontwerp dat volledig om zelforganisatie draait, moest de instroom worden geregeld.
De auteurs beschrijven ook gedrag dat ontstond naarmate de groep groeide: bij 8 agents spraken werkers een interface af en bouwden die elk los van elkaar; bij 128 kozen ze reviewers op basis van wie aan verwante code had gewerkt; bij 1.024 namen meerdere werkers de integratie op zich en pakten werkers taken op die anderen hadden laten liggen.
Het artikel meldt voor geen enkele run wat die kostte: geen tokentotalen, geen API-uitgaven, geen rekenkracht per gewonnen punt. Het geeft de limieten per werker — tot 272.000 inputtokens en 128.000 outputtokens — en een budget van zes uur, en verder niets.
Dat doet ertoe, want de opschalingsclaim is eigenlijk een prijsclaim. '128 keer zoveel agents voor 9,5 punten' is alleen een goede ruil als je weet wat 128 keer zoveel kost. Zonder dat laten de resultaten zien dat meer agents kunnen helpen, niet dat ze het waard zijn. Ik ga de kosten niet schatten op basis van de tokenlimieten. Werkers gebruiken niet per se hun hele budget, en een schatting zou preciezer lijken dan ze is.
De vraag die je bij elk opschalingsresultaat moet stellen
Niet 'ging de score omhoog?', maar 'hoeveel punten per dollar bij elke stap, en hoeveel minuten bespaard?'. Dat zijn de twee getallen die bepalen of de volgende verdubbeling het kopen waard is.
Je hebt geen 1.024 agents nodig om dit ontwerp te gebruiken. Het meeste is nuttig zodra je er meer dan één draait.
Elke agent schrijft op wat hij oppakt voordat hij start. Onze eerdere analyse van werk verdelen over vijf coding agents liet zien dat agents isoleren het makkelijke deel is en dat ze botsen bij het landen van hun werk: één studie uit 2026 vond tekstuele mergeconflicten bij 27,67% van de pull requests van agents. Een zichtbare claim, gemaakt voordat het werk begint, is de goedkoopste manier om zowel botsingen als dubbel werk te beperken.
Een FAIL-regel voorkomt dat elke volgende agent dezelfde doodlopende weg inslaat. Het is de waardevolste regel in de log, en de regel die de meeste opstellingen niet vastleggen.
Privé-branches, één main branch, en conflicten opgelost door de agent die ze veroorzaakte. Die infrastructuur heb je al, en ze legt al vast wie wat deed.
Werkers in Agensh toetsen hun werk aan de criteria van de subtaak voordat ze mergen. Zonder die criteria betekent 'klaar' wat de agent ervan maakt.
Als Microsoft op deze schaal de starts moest spreiden, zullen vijf agents die tegelijk dezelfde lege takenlijst lezen ook botsen. Een korte pauze tussen starts kost niets.
Leg vast hoe lang het duurt om 'goed genoeg' te halen met 1, 2 en 4 agents op je eigen werk. Samen met de kosten vertelt dat je waar je moet stoppen met agents toevoegen.
Het is een preprint. Niet peer-reviewed, en de resultaten komen van één team op één benchmark.
Het zijn vijf taken en één model. En maar één taak is met 1.024 agents gedraaid. Het patroon hoeft niet te gelden voor andere taken of andere modellen.
Er is geen vergelijking met een orchestrator. Het artikel stelt dat een centrale orchestrator samenwerking beperkt, maar vergelijkt Agensh niet met een georkestreerd systeem op dezelfde taken. Of het weghalen van de baas de winst veroorzaakte, weten we uit dit artikel niet.
Ik heb geen spreiding gevonden. Of de stap van 32 naar 128 agents groter is dan de ruis tussen runs, kan ik met wat gepubliceerd is niet controleren.
ProgramBench heeft een ongewoon duidelijke antwoordsleutel. De agents kunnen het referentieprogramma draaien en uitkomsten op elk moment vergelijken. Het meeste echte softwarewerk heeft zo'n orakel niet, en verifiëren is daar veel moeilijker. Het ontwerp schaalt mogelijk minder goed waar 'correct' een kwestie van oordeel is.
De kosten zijn onbekend. Sectie 5 is een klacht over ontbrekende data, geen conclusie dat de winst te duur is.
Agensh laat zien dat coding agents kunnen samenwerken op een schaal waar een centrale baas het niet meer bijhoudt, met infrastructuur die de meeste teams al hebben: git, een berichtenkanaal en een gedeelde log. Dat ontwerp is nuttig bij vijf agents, en het meeste kost niets om over te nemen.
Het opschalingsresultaat is bescheidener dan de kop. Van 1 naar 128 agents leverde zo'n 9,5 punten op bij de zwaarste taken. Van 128 naar 1.024 leverde zo'n 4 op bij de enige taak waar het is geprobeerd. De duidelijkste winst was snelheid. En het artikel laat precies het getal weg dat zou zeggen of het de moeite waard is om ervoor te betalen.
Neem deze week de claimlog en de faallog over. Meet voordat je meer agents toevoegt wat elke extra agent je oplevert, in minuten en in geld.
Bron: Zhihao Zhan, Ting Song, Li Dong, Shaohan Huang, Jianxun Lian, Yan Xia en Furu Wei, 'Agensh: Scaling Organizational Intelligence to 1,024 Agents', Microsoft Research, arXiv:2609.26781v1, 22 september 2026: de opzet van ProgramBench, de selectie van vijf taken, het model en de tokenlimieten, de gemiddelde slagingspercentages van 19,31%, 20,68%, 26,52% en 28,78%, de pandoc-cijfers van 33,89%, 50,94% en 55,06%, de relatieve verbetering van ongeveer 49%, de drempeltijden van 30, 60 en 90 minuten, de drie infrastructuuronderdelen en getypeerde contextregels, het gespreide startschema en het emergente gedrag, alles zoals daar gerapporteerd. De puntverschillen in sectie 2 zijn mijn eigen berekening op basis van die cijfers. De interpretaties in secties 3 tot en met 6 zijn van mij. Voor de eerdere vraag hoe je werk over een handvol coding agents verdeelt, zie twee manieren om werk over vijf coding agents te verdelen. Voor waarom een agent die alles leest meer kost dan het lijkt, zie elk bestand dat je agent leest, blijft op de rekening staan.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.