Les sondés IA disaient que 98 % connaissaient la réponse. Chez les vraies personnes, 52 %. Ne validez pas votre startup avec des utilisateurs synthétiques

By Surya Pratap
1 octobre 2026
9 min read
MVP Strategy

1 octobre 2026
9 min read
 Sûrs d'eux, modérés, et à côtéHover to explore
De plus en plus de fondateurs valident leurs idées sans parler à personne. Ils décrivent leur client cible à un modèle de langage, génèrent quelques centaines d'« utilisateurs synthétiques » et leur demandent s'ils achèteraient. Les réponses arrivent vite, coûtent peu et paraissent sûres d'elles. Pew Research vient de tester cette même idée face à de vraies personnes, avec soin, et c'est justement cette assurance qui pose problème.
Les chiffres proviennent de deux rapports du Pew Research Center publiés le 30 septembre 2026 par Athena Chapekis, Arnold Lau, Samuel Bestvater, Sono Shah, Andrew Mercer et Aaron Smith : « Can AI stand in for human survey takers? Not really » et « How synthetic polling results change based on the AI model ». Pew a étudié des sondages d'opinion, pas de la recherche produit. L'application de ces résultats aux fondateurs est mon interprétation, à partir de la section 3.
Pew gère l'American Trends Panel, un large panel d'adultes américains réels qu'il interroge régulièrement. Pour cette étude, il a créé un « jumeau numérique » de chaque membre du panel : on a fourni à un modèle d'IA les données démographiques de la personne et ses réponses à une précédente enquête de typologie politique, puis on lui a demandé de répondre à de nouvelles enquêtes comme l'aurait fait cette personne.
Les jumeaux ont répondu à trois vraies enquêtes du début de 2026, soit environ 300 questions au total, avec la même formulation et les mêmes consignes que les humains. Pew a ensuite comparé leurs réponses à celles des vraies personnes. Le modèle principal était Claude Opus 4.6, d'Anthropic. Un second rapport a refait l'exercice avec GPT-5.1, d'OpenAI.
C'est presque le meilleur cas possible pour des répondants synthétiques. Chaque jumeau a été construit à partir des propres réponses détaillées d'une personne réelle, et non d'une courte description de persona.
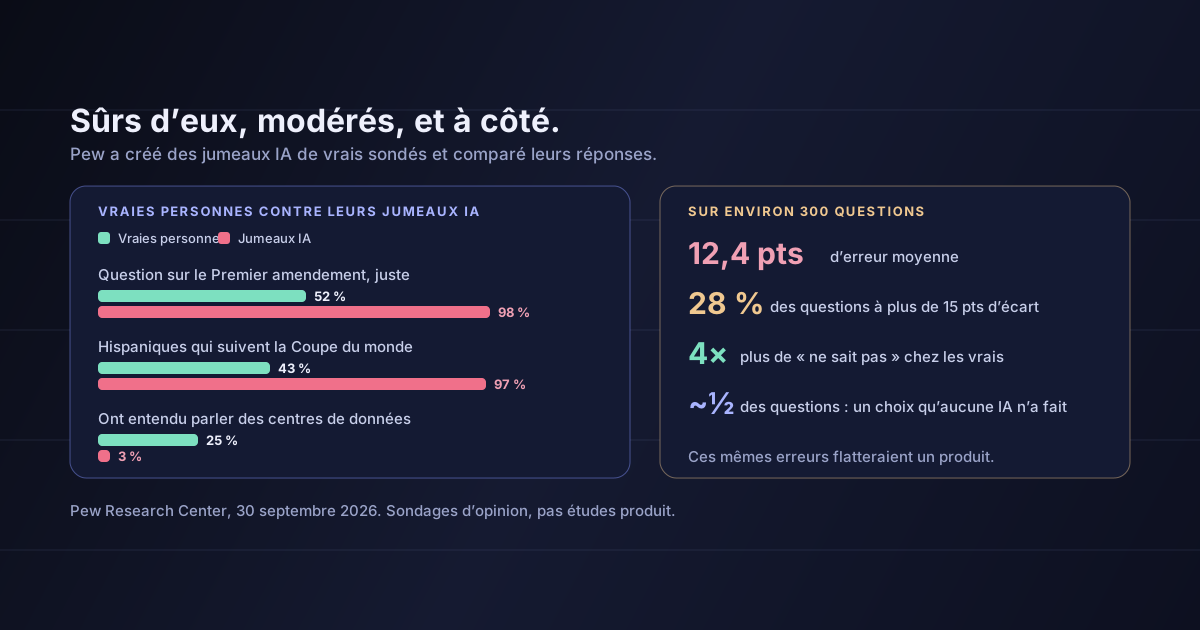
Sur les trois enquêtes, les réponses de l'IA s'écartaient des vraies de 12,4 points de pourcentage en moyenne. Sur environ 28 % des questions, l'erreur dépassait 15 points, et les écarts de 20 à 40 points sur des réponses précises étaient fréquents.
Quelques exemples montrent la forme de ces erreurs :
La conclusion de Pew : les modèles d'IA ne sont « pas un substitut adéquat » à l'interrogation de vraies personnes sur des sujets d'importance générale, et leurs résultats « diffèrent de façon souvent imprévisible ».
Les jumeaux avaient été construits à partir des propres réponses des vraies personnes, et ils s'en écartaient pourtant de douze points en moyenne.
Pew a relevé des schémas constants dans la façon dont l'IA se trompait. Chacun correspond à une question que les fondateurs sont tentés de poser à des utilisateurs synthétiques.
Ils en savent trop. Les jumeaux IA répondaient juste aux questions de connaissances bien plus souvent que les vraies personnes : 98 % contre 52 % sur l'une d'elles. Un client synthétique comprendra votre catégorie, votre jargon et votre proposition de valeur. La plupart de vos vrais clients, non, et c'est dans cet écart que les produits échouent.
Ils doutent rarement. Les vraies personnes ont choisi « je ne sais pas » environ quatre fois plus souvent que l'IA. En recherche client, « je ne sais pas, je n'y ai jamais pensé » est souvent la réponse la plus importante qu'on puisse obtenir. Les utilisateurs synthétiques ne la donnent presque jamais.
Ils évitent les extrêmes. Sur près de la moitié des questions, au moins une réponse proposée n'a été choisie par aucun répondant IA. Ceux qui n'achèteraient jamais, et le petit groupe qui achèterait dès demain, sont précisément ceux qu'un échantillon synthétique laisse de côté.
Ils jouent le stéréotype. Les jumeaux IA répondaient comme la caricature de leur groupe : 97 % des jumeaux hispaniques suivaient la Coupe du monde contre 43 % en réalité, 95 % des jumeaux républicains avaient une opinion favorable d'Israël contre 58 %. Décrivez votre client idéal, et le modèle répondra comme le cliché de ce client.
Le cinquième défaut compte le plus pour tout ce qui est nouveau. Les plus gros écarts portaient sur l'actualité récente — la question sur les centres de données était fausse de 22 points —, alors même que le modèle avait accès aux tendances antérieures. Une nouvelle catégorie de produits est, par définition, quelque chose que les vraies personnes n'ont encore jamais rencontré. C'est exactement la situation où les réponses synthétiques sont les moins fiables.
Le second rapport de Pew a fait tourner les mêmes jumeaux numériques sur deux modèles différents. Ils se contredisaient autant entre eux qu'avec la réalité.
Un modèle rendait tout le monde modéré. L'autre rendait tout le monde extrême. Le résumé de Pew : chaque échantillon synthétique « a dressé un portrait très différent du public américain », et « aucun ne reflétait vraiment l'opinion publique réelle ».
Pour un fondateur, cela signifie que le « marché » décrit par une étude d'utilisateurs synthétiques dépend en partie du modèle que vous utilisez. Changez de modèle, et votre courbe de consentement à payer se déplace.
Pew ne dit pas que l'IA est inutile en recherche. Il cite deux usages où elle aide : classer les vraies réponses aux questions ouvertes, et écrire le code d'analyse des résultats. Dans les deux cas, l'IA traite ce que de vraies personnes ont dit au lieu de l'inventer.
Pour les fondateurs, la même règle donne une liste utile :
Demandez à un modèle de suggérer des questions, puis supprimez celles qui orientent la réponse. C'est rapide, et rien de ce qu'il produit n'est traité comme une preuve.
Soumettez votre questionnaire à un modèle pour repérer les questions confuses ou doubles avant que de vraies personnes ne le voient.
Faites jouer un acheteur sceptique pour vous entraîner à votre pitch. Considérez-le comme un sparring-partner, pas comme une prévision de ce que diront les acheteurs.
Après avoir parlé à de vraies personnes, utilisez un modèle pour étiqueter les thèmes de vos notes. C'est l'usage que Pew approuve.
Ce qu'il ne peut pas faire, c'est vous dire si les gens veulent ce que vous construisez, combien ils sont, ni combien ils paieraient.
Cinq vraies conversations avec des personnes qui ont le problème vous en apprendront plus que cinq cents conversations synthétiques, parce qu'elles peuvent vous surprendre. Elles peuvent dire « je ne sais pas », « jamais entendu parler » ou « on a réglé ça avec un tableur il y a des années » — exactement les réponses que, selon Pew, l'IA ne donne presque jamais.
Si vous n'avez encore jamais organisé ces conversations, nos guides sur la préparation d'un appel de découverte et sur la transformation de l'intérêt d'une communauté en premier client payant en expliquent le déroulé.
Pew a étudié l'opinion publique, pas la demande pour un produit. Les questions portaient sur la politique, l'actualité et les connaissances. J'applique ces schémas à la recherche client parce que le mécanisme est le même, mais Pew n'a pas testé de questions sur des produits.
Deux modèles ont été comparés. Claude Opus 4.6 était le modèle principal, et la comparaison a ajouté GPT-5.1. Le chiffre principal de 12,4 points est la moyenne sur trois enquêtes ; la comparaison entre modèles donne 11,4 points pour Claude et 13,3 pour GPT sur les questions qu'elle couvrait. D'autres modèles, prompts ou méthodes pourraient faire mieux ou moins bien.
De meilleures méthodes pourraient réduire l'écart. Pew le dit lui-même : de nouveaux modèles et de nouvelles façons de construire des échantillons synthétiques pourraient produire des erreurs plus faibles. C'est une mesure de la situation actuelle, pas une limite définitive.
Vos utilisateurs synthétiques reposent sans doute sur moins d'informations. Les jumeaux de Pew ont été construits à partir des propres réponses détaillées de chaque personne. La plupart des personas de fondateurs tiennent en un paragraphe de description. Cela laisse penser que des utilisateurs synthétiques créés par un fondateur feraient pire, mais c'est mon inférence, pas un résultat testé par Pew.
Pew a construit la version la plus soignée de répondants synthétiques que la plupart des fondateurs pourraient espérer — des jumeaux IA de vraies personnes, construits à partir de leurs propres réponses — et ils se sont malgré tout trompés d'environ 12 points en moyenne. Ils en savaient plus que les vraies personnes, étaient plus sûrs d'eux, évitaient les extrêmes et répondaient comme le stéréotype de leur groupe. Ils faisaient pire sur les sujets nouveaux. Et changer de modèle changeait le portrait.
Pour une startup, ce ne sont pas des cas marginaux. Ce sont exactement les erreurs qui feraient paraître un produit plus désiré, mieux compris et plus largement attrayant qu'il ne l'est vraiment.
Utilisez l'IA pour préparer vos conversations avec les clients et pour les analyser. Pas pour les remplacer.
Sources : Athena Chapekis, Arnold Lau, Samuel Bestvater, Sono Shah, Andrew Mercer et Aaron Smith, « Can AI stand in for human survey takers? Not really », Pew Research Center, 30 septembre 2026 — la méthode des jumeaux numériques, les trois enquêtes de l'American Trends Panel du début de 2026 et leurs quelque 300 questions, l'erreur moyenne de 12,4 points, la part des questions au-delà de 15 points, les exemples des centres de données, du Premier amendement, de l'OTAN et de la Coupe du monde, l'écart de quatre fois sur « je ne sais pas », les réponses qu'aucun répondant IA n'a choisies, les exemples de stéréotypes et les conclusions de Pew sur ce que l'IA peut et ne peut pas faire. Les mêmes auteurs, « How synthetic polling results change based on the AI model », Pew Research Center, 30 septembre 2026 — la comparaison entre Claude Opus 4.6 et GPT-5.1, les erreurs de 11,4 et 13,3 points, les taux de réponses médianes, les exemples de désaccord entre modèles et la réserve sur les méthodes futures. Les citations sont reproduites ici en traduction. L'application à la recherche client des sections 3 à 6 est la mienne.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.