Un modèle de programmation généraliste sait écrire du React et du Python comme les écrit l'internet ouvert. Il ne connaît pas les frontières entre modules de votre monorepo, votre framework RPC interne, le wrapper d'authentification que chaque service est censé utiliser, ni le fait que votre équipe a banni un motif il y a trois ans après une panne. Cet écart, entre la façon dont le monde code et celle dont votre entreprise code, est exactement ce que comble un modèle affiné. Et en 2026, construire la pile pour y parvenir est bien plus accessible que ne le pensent la plupart des responsables techniques.
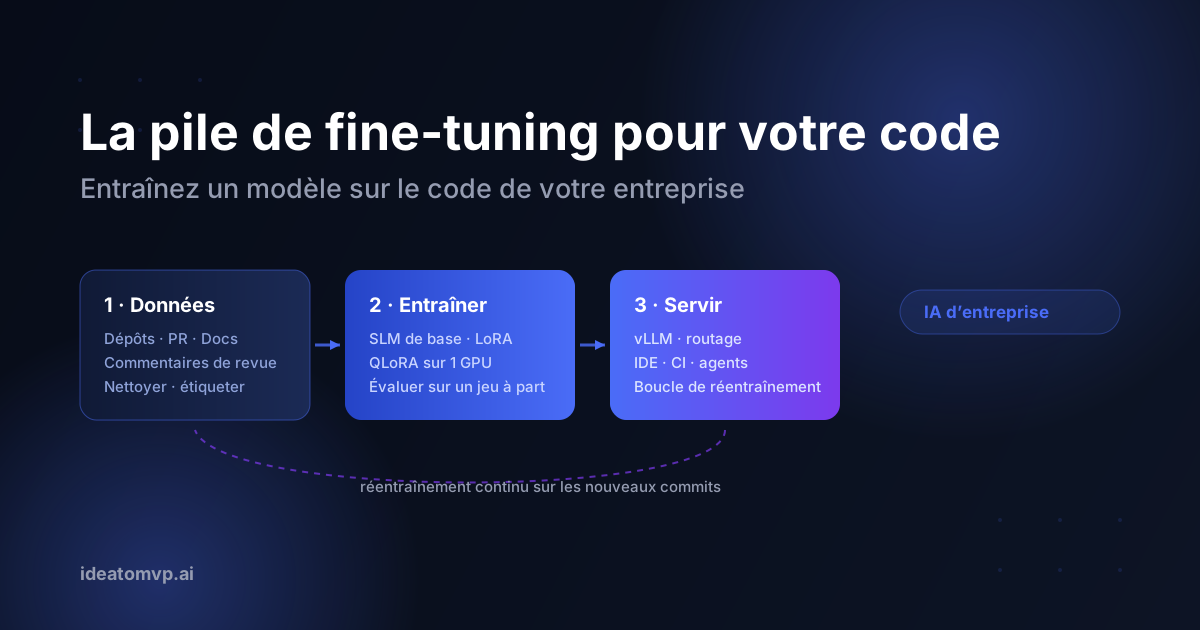
Voici un parcours pratique, couche par couche, de la pile nécessaire pour faire le fine-tuning d'un modèle sur une base de code d'entreprise donnée : le pipeline de données, le choix du modèle de base, la couche d'entraînement, l'évaluation, la mise en service et la boucle de réentraînement qui garde le modèle à jour à mesure que votre code évolue. Il aborde aussi la décision qui vient en premier : faut-il seulement faire du fine-tuning, ou la récupération suffira-t-elle ?
D'abord : fine-tuning, RAG ou long contexte ?
Avant de réserver le moindre GPU, soyez honnête sur le problème que vous résolvez. Trois outils sont en concurrence ici, et ils ne sont pas interchangeables :
- La récupération (RAG) apprend des faits. « Que fait cette fonction ? Où est défini le client de paiement ? » Si votre besoin est d'ancrer les réponses dans le code et la documentation actuels, un RAG sur un index vectoriel de votre dépôt est moins cher, plus rapide à livrer et se met à jour dès que le code change. Commencez par là.
- Le fine-tuning apprend des comportements et un style. « Écris du code comme nous l'écrivons. » Les conventions de nommage, les idiomes de gestion d'erreurs, les bibliothèques préférées, la structure maison d'un service : des motifs trop diffus pour tenir dans un prompt et trop constants pour être laissés à un modèle générique. C'est là que le fine-tuning excelle.
- Le long contexte gère le ponctuel. Pour une seule grosse tâche, coller les fichiers pertinents dans la fenêtre de contexte d'un modèle de pointe suffit souvent. Cela ne passe pas à l'échelle pour chaque développeur, chaque jour, à un coût prévisible, et c'est précisément pourquoi les équipes finissent par passer au fine-tuning.
La réponse mature est généralement fine-tuning plus RAG : un modèle qui a intégré votre style et vos conventions, et qui récupère votre code actuel au moment de l'inférence pour que ses faits ne soient jamais périmés. La suite de ce guide construit cette combinaison.
Couche 1 : le pipeline de données (80 % du travail)
Tout praticien honnête vous dira la même chose : le modèle, c'est facile ; le projet, ce sont les données. Un fine-tuning ne vaut que par les exemples dont il apprend, et une base de code d'entreprise est une source désordonnée. Le pipeline compte quatre étapes.
- Collecter. Puisez dans les sources qui reflètent réellement la façon dont votre équipe construit : les dépôts de code, les pull requests fusionnées et leurs commentaires de revue, les documents de conception internes et les ADR, les tickets résolus et les runbooks. Les PR et les fils de revue sont de l'or : ils capturent non seulement le code, mais aussi le raisonnement et les corrections.
- Nettoyer et filtrer. Retirez les secrets et identifiants (non négociable, et à faire avant que quoi que ce soit n'atteigne un serveur d'entraînement), supprimez le code généré, les dépendances embarquées et les lockfiles, écartez les modules morts et obsolètes, et dédoublonnez les fichiers quasi identiques pour que le code répétitif ne domine pas le signal.
- Mettre en forme les exemples. Choisissez le format de la tâche. Pour un modèle d'autocomplétion, utilisez des exemples fill-in-the-middle (FIM) tirés de vrais fichiers. Pour un assistant qui suit des instructions, construisez des paires instruction–réponse : « Ajoute un endpoint paginé à ce service » associé au diff réel qui l'a fait. Le titre et la description d'une PR comme instruction, le diff fusionné comme réponse : c'est une source puissante et presque gratuite de données d'instruction.
- Séparer et réserver. Mettez de côté un jeu de test avant l'entraînement, idéalement les commits les plus récents, pour que votre évaluation imite l'usage réel : prédire du code que le modèle n'a jamais vu. Ne laissez jamais les fichiers de test fuiter dans l'entraînement.
Le verrou licences et confidentialité
Vos données d'entraînement sont votre propriété intellectuelle la plus sensible. C'est la principale raison de faire tourner toute la pile sur une infrastructure que vous contrôlez : un VPC privé, des GPU réservés ou du matériel sur site. Vérifiez que vous avez le droit d'entraîner sur chaque source (attention au code tiers et sous licence copyleft présent dans le monorepo), supprimez les données personnelles et les secrets, et consignez exactement ce qui est entré dans chaque entraînement. Quand la pile vous appartient, cela devient une propriété de l'architecture plutôt qu'une promesse du fournisseur.
Couche 2 : choisir le modèle de base
Vous n'entraînez pas un modèle de zéro : vous adaptez une solide base à poids ouverts qui comprend déjà la programmation. Choisissez parmi la génération actuelle de modèles de code ouverts (les familles Qwen-Coder, Code Llama, DeepSeek-Coder et StarCoder, plus de petits modèles généralistes comme Phi et Gemma). Trois critères guident le choix :
- La taille face à la tâche. Pour l'autocomplétion en ligne et des tâches d'assistant ciblées, un modèle de 3B à 8B affiné sur votre code est rapide, peu coûteux à servir, et bat souvent un modèle générique bien plus gros sur vos motifs propres. Réservez les 14B à 34B au vrai raisonnement multi-fichiers. La taille n'est pas l'objectif ; l'adéquation, si.
- La licence. Vérifiez que les poids autorisent l'usage commercial et interne. C'est une case juridique à cocher, pas un détail : réglez-la avant de construire sur une base.
- La longueur de contexte et la prise en charge du FIM. Les tâches de code s'étendent sur plusieurs fichiers : privilégiez les bases à long contexte et entraînées nativement au fill-in-the-middle si l'autocomplétion est votre cas d'usage.
Couche 3 : la couche d'entraînement (LoRA / QLoRA)
Vous n'avez presque certainement pas besoin d'un fine-tuning complet. Les méthodes économes en paramètres, LoRA et sa variante quantifiée QLoRA, entraînent un petit ensemble de poids d'adaptateur au-dessus d'une base figée : vous pouvez donc adapter un modèle de 7B sur un seul GPU moderne en quelques heures, pour le prix d'un bon dîner. L'outillage est mûr : des bibliothèques comme Hugging Face PEFT, Axolotl et Unsloth encapsulent toute la boucle.
Ce qui compte vraiment dans cette couche :
- Les adaptateurs gardent l'ensemble modulaire. Comme un adaptateur LoRA est un petit fichier distinct des poids de base, vous pouvez entraîner un adaptateur par équipe, par langage ou par service, et les permuter au moment de la mise en service. Le réentraînement est bon marché et le rayon d'impact limité.
- Prémunissez-vous contre l'oubli catastrophique. Sur-entraîner sur une base de code étroite peut dégrader le modèle en programmation générale. Mélangez une part de données de code généralistes, gardez des taux d'apprentissage modérés et arrêtez tôt selon votre courbe d'évaluation, pas selon un nombre d'époques fixé à l'avance.
- Suivez chaque entraînement. Versionnez ensemble le jeu de données, le modèle de base, les hyperparamètres et l'adaptateur obtenu. Quand un modèle régresse, vous devez savoir exactement ce qui a changé.
Côté calcul : louez avant d'acheter. Un GPU cloud réservé (une A100 ou une H100 chez CoreWeave, Lambda ou dans l'offre réservée d'un hyperscaler) est le bon point d'entrée. Ne passez à du matériel en propre qu'une fois les volumes d'entraînement et d'inférence assez stables pour le justifier.
Couche 4 : l'évaluation (la couche que les équipes sautent et regrettent)
Un fine-tuning qui « a l'air mieux » en démo n'est pas un résultat. Ce qui sépare un programme de modèles en production d'un projet scientifique, c'est un vrai harnais d'évaluation exécuté à chaque réentraînement. Pour le code, vous disposez d'options exceptionnellement bonnes :
- Des tests fondés sur l'exécution. Le code se vérifie. Générez des complétions pour des tâches réservées, exécutez-les contre vos vrais tests unitaires et mesurez combien passent. Construisez un jeu interne façon SWE-bench à partir de vos propres tickets résolus et de leurs tests : c'est le signal le plus honnête que vous puissiez obtenir.
- Des contrôles de style et de conventions. Faites passer le code généré par vos linters, formateurs et vérificateurs de types. Un modèle qui a intégré vos conventions produit du code qui franchit proprement vos barrières de CI.
- Un face-à-face avec la référence. Comparez toujours le modèle affiné au modèle de base brut et à une API de pointe performante sur la même tâche. S'il ne bat pas les deux sur votre métrique, vous avez appris quelque chose de précieux avant de le livrer.
Couche 5 : la mise en service et la couche applicative
Un adaptateur entraîné qui dort dans un stockage objet n'aide personne. La couche de mise en service est l'endroit où le modèle rencontre les développeurs :
- Le serveur d'inférence. Servez avec vLLM, TGI ou Ollama pour une inférence à haut débit et faible latence, essentielle pour l'autocomplétion, où tout ce qui dépasse quelques centaines de millisecondes paraît cassé. Quantifiez (GPTQ/AWQ) pour faire tenir plus de requêtes simultanées sur chaque GPU.
- La récupération au moment de l'inférence. Associez le modèle affiné à un RAG sur votre dépôt actuel pour qu'il ait le style intégré et des faits à jour dans son contexte. C'est tout l'intérêt du fine-tuning plus RAG.
- La surface de livraison. Exposez-le là où les développeurs travaillent déjà : une extension d'IDE pour l'autocomplétion, un endpoint de chat pour les questions, un bot de CI pour la revue, ou un outil au sein d'un workflow agentique.
- Le routage. Vous n'êtes pas obligé de servir chaque requête depuis votre modèle. Envoyez les requêtes fréquentes et propres au domaine à votre modèle affiné, et escaladez les rares requêtes vraiment difficiles et ouvertes vers une API de pointe. Placez chaque requête sur la couche la moins chère qui la traite bien.
Couche 6 : la boucle de réentraînement
Une base de code est une cible mouvante. Le modèle entraîné au premier trimestre est subtilement faux au troisième, parce que vos conventions, vos dépendances et votre architecture ont évolué. La dernière pièce de la pile est une boucle, pas un jalon : chaque mois ou chaque trimestre, injectez les PR fusionnées récentes dans le pipeline, réentraînez l'adaptateur, lancez le harnais d'évaluation et ne promouvez le nouvel adaptateur que s'il bat le titulaire sur vos métriques. Chaque cycle creuse l'écart entre votre modèle et tout ce qu'un concurrent peut obtenir en promptant un modèle générique, car cet écart est votre savoir d'ingénierie accumulé.
La pile en un coup d'œil
- Données : collecter dépôts, PR et docs → nettoyer, dédoublonner, retirer les secrets → mettre en forme en paires FIM ou d'instructions → réserver les commits récents.
- Modèle de base : un modèle de code à poids ouverts dimensionné pour la tâche, avec une licence claire et un long contexte.
- Entraînement : LoRA/QLoRA via PEFT, Axolotl ou Unsloth sur un GPU réservé, avec des entraînements versionnés et des garde-fous contre l'oubli.
- Évaluation : tests d'exécution, contrôles de lint et de types, et comparaisons directes avec des références sur un jeu réservé.
- Mise en service : vLLM/TGI + RAG, livré dans l'IDE, la CI ou un agent, avec routage vers une API de pointe pour les cas difficiles.
- Réentraînement : une boucle planifiée qui garde l'adaptateur à jour à mesure que le code évolue.
En résumé
Faire le fine-tuning d'un modèle sur la base de code de votre entreprise n'est plus un effort de recherche réservé aux laboratoires d'IA : c'est un projet d'ingénierie avec une pile éprouvée. Un pipeline de données rigoureux, une base à poids ouverts, quelques heures d'entraînement LoRA sur un GPU loué, un vrai harnais d'évaluation, une couche de mise en service rapide et une boucle de réentraînement. Soignez les données et le reste n'est que plomberie. Vous obtenez une intelligence qu'aucun concurrent ne peut acheter ni obtenir à coups de prompts : un modèle qui écrit du code comme votre organisation l'écrit.
Si vous vous demandez par où commencer (faire du fine-tuning ou miser sur la récupération, quelle tâche adapter en premier, ou comment monter le pipeline en toute sécurité sur votre propre infrastructure), réservez un appel de découverte gratuit et nous dessinerons la pile avec vous.
IdeaToMVP Academy
Want to build with AI — not just read about it?
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.