LangChain v1 en 2026 : la nouvelle stack pour construire des agents (ce qu'en disent Reddit et X)

By Surya Pratap
20 avril 2026
10 min read
AI & Technology

20 avril 2026
10 min read
 LangChain v1Hover to explore
Pendant la majeure partie de 2023 et 2024, les avis les plus bruyants sur LangChain sur r/LangChain, r/LocalLLaMA et X/Twitter se ressemblaient tous : « génial pour les démos, pénible en production ». Des wrappers empilés sur des wrappers, des abstractions qui fuyaient dès qu'il fallait une vraie boucle, et une feuille de route qui semblait sortir une nouvelle chaîne chaque mardi. Avec LangChain v1 (stable depuis fin 2025), l'histoire a changé. Le framework assume désormais sa forme d'agent : un point d'entrée de haut niveau, create_agent, un système de middleware, et LangGraph comme runtime par défaut sous le capot.
Cet article s'appuie notamment sur l'annonce officielle de LangChain v1, la documentation des agents LangChain, les discussions récurrentes sur r/LangChain et r/LocalLLaMA, et des fils de @LangChainAI et @hwchase17 sur X. Les tendances priment sur les citations choisies.
Le changement majeur, c'est que LangChain n'est plus un sac de chaînes. Le package principal s'articule désormais autour de trois éléments :
Les anciennes briques (LLMChain, AgentExecutor, initialize_agent, create_react_agent dans son ancienne forme) restent importables mais sont marquées comme héritées. Le nouveau code est censé vivre dans langchain.agents et langchain.messages, avec les intégrations des fournisseurs dans langchain-openai, langchain-anthropic et consorts.
from langchain.agents import create_agent
from langchain.tools import tool

@tool
def get_weather(city: str) -> str:
    """Return the current weather for a given city."""
    return f"It's 24C and sunny in {city}."

agent = create_agent(
    model="anthropic:claude-sonnet-4-5",   # or "openai:gpt-5", "google:gemini-2.5-pro"
    tools=[get_weather],
    system_prompt="You are a concise travel assistant.",
)

result = agent.invoke(
    {"messages": [{"role": "user", "content": "Weather in Lisbon?"}]}
)
print(result["messages"][-1].content)
Trois choses à remarquer : le modèle est une chaîne de caractères (LangChain se charge de résoudre le fournisseur), les outils sont de simples fonctions Python décorées avec @tool, et il n'y a ni prompt ReAct explicite ni parseur. La boucle de l'agent, le protocole d'appel d'outils et les réducteurs de messages vivent tous dans le runtime.
L'une des fonctionnalités v1 les mieux notées sur r/LangChain est response_format. Passez un modèle Pydantic et l'agent produit un objet validé dans la même boucle : pas de parseur supplémentaire, pas d'appel de suivi du type « maintenant, extrais ça en JSON ».
from pydantic import BaseModel
from langchain.agents import create_agent

class TripPlan(BaseModel):
    city: str
    days: int
    must_do: list[str]

agent = create_agent(
    model="openai:gpt-5",
    tools=[get_weather],
    response_format=TripPlan,
)

out = agent.invoke({"messages": [
    {"role": "user", "content": "Plan 3 days in Lisbon."}
]})

plan: TripPlan = out["structured_response"]
print(plan.must_do)
C'est avec le middleware que la v1 cesse de ressembler à un wrapper pour devenir un vrai framework d'agents. Vous pouvez vous brancher sur before_model, after_model, before_tool et after_tool, et livrer des comportements réutilisables comme :
from langchain.agents import create_agent
from langchain.agents.middleware import (
    HumanInTheLoopMiddleware,
    SummarizationMiddleware,
    PIIMiddleware,
)

agent = create_agent(
    model="anthropic:claude-sonnet-4-5",
    tools=[refund_order, send_email, query_db],
    middleware=[
        PIIMiddleware(strategy="redact"),
        SummarizationMiddleware(max_tokens_before_summary=12_000),
        HumanInTheLoopMiddleware(
            interrupt_on={"refund_order": True, "send_email": True}
        ),
    ],
)
C'est la brique qui, dans notre propre travail pour nos clients comme dans les fils récents sur X, rend enfin LangChain livrable : les problèmes épineux de production se composent au lieu d'être collés au niveau du prompt.
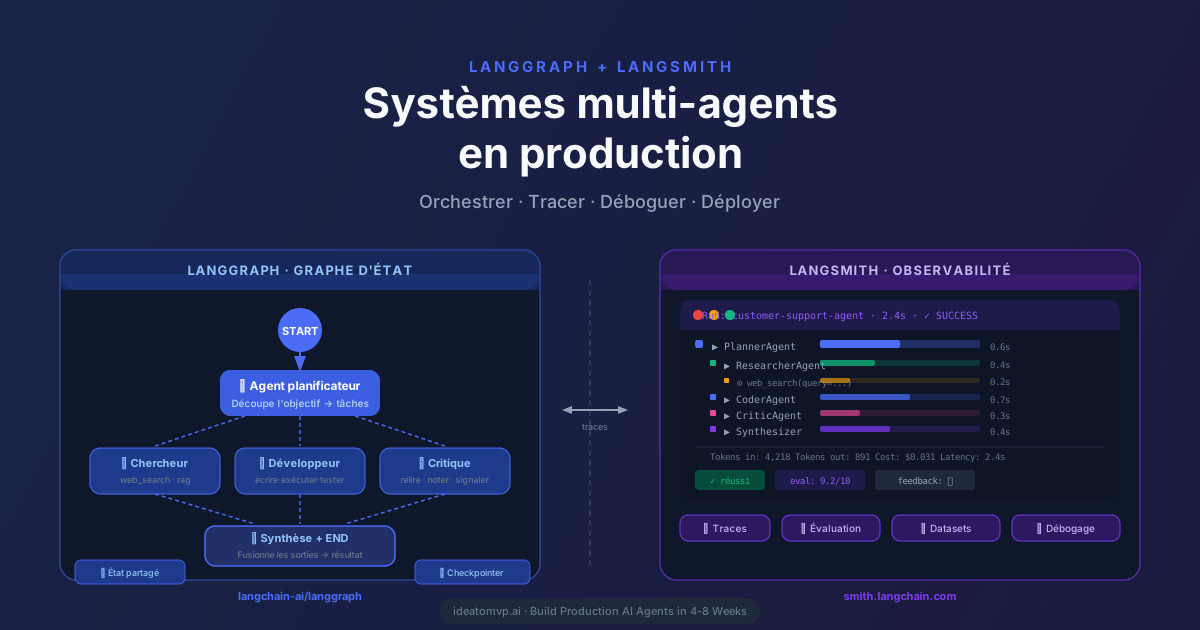
 Avec état par défautHover to explore
Pour les configurations multi-agents, LangChain s'appuie sur LangGraph et sur deux composants prêts à l'emploi souvent cités sur Reddit :
create_agent dans un StateGraph quand vous voulez un contrôle total sur les arêtes et la forme de l'état.Sur les derniers mois de r/LangChain, r/LocalLLaMA et des recoins d'X consacrés à l'ingénierie IA, les thèmes récurrents sont les suivants :
create_agent, c'est ce que ça aurait dû être il y a deux ans. » Le middleware et la sortie structurée sont les gains les plus cités. Les traces LangSmith « marchent, tout simplement », sans cérémonie.langchain, langchain-core, langgraph, packages des fournisseurs) piège encore les nouveaux venus. La migration depuis du code 0.x est « surtout mécanique, parfois chirurgicale ».« En 2026, la question intéressante n'est plus "quel framework". C'est : lequel vous permet de livrer le même agent sur trois fournisseurs, avec une validation humaine et une trace pour chaque échec. »
create_agent + 2 à 5 outils + response_format. Laissez le middleware de côté le premier jour.LangChain v1 est la première version dont la forme correspond à la façon dont les équipes construisent réellement des agents en production : une boucle qui utilise des outils avec un graphe en dessous, des hooks pour les sujets ingrats (données personnelles, validations, résumé, nouvelles tentatives), et le même chemin de code quel que soit le fournisseur. La conversation sur Reddit et X est passée de « LangChain, c'est un mème ? » à « votre agent est-il observable, récupérable et portable ? ». Pour les fondateurs qui livrent un MVP en 2026, c'est un bien meilleur débat.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.