
Entraîner GLM et d'autres modèles ouverts sur votre propre code : ce que cela vous apporte vraiment (2026)

By Surya Pratap
29 juillet 2026
11 min read
AI & Technology

29 juillet 2026
11 min read
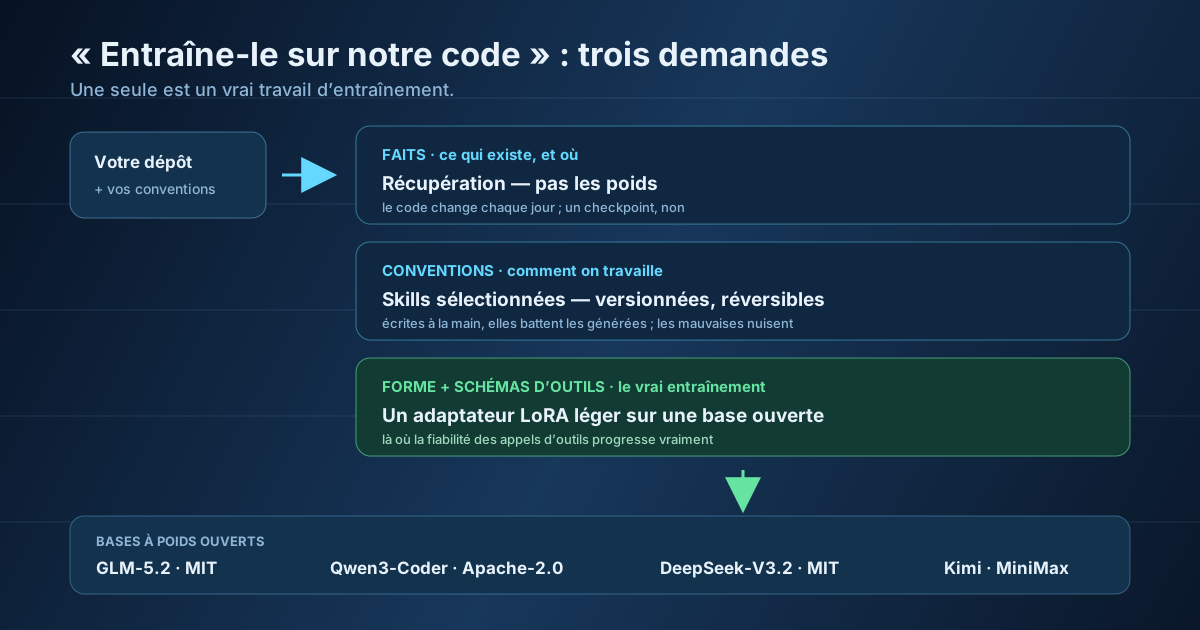
Toutes les quelques semaines, un fondateur pose une variante de la même question : peut-on prendre un modèle ouvert comme GLM, l'entraîner sur notre base de code et obtenir un agent qui code comme notre équipe code ? C'est un bon réflexe, et en 2026 il devient enfin raisonnable : l'offre à poids ouverts est assez solide pour bâtir dessus, et un fine-tuning qui coûtait autrefois des dizaines de milliers coûte aujourd'hui moins qu'un déjeuner. Mais la demande cache un piège. « Entraînez-le sur notre code » recouvre en réalité trois demandes distinctes sous le même manteau, et une seule est un travail d'entraînement. Les équipes qui lancent un fine-tuning avant de les séparer passent un mois à produire un modèle qui écrit dans le style maison et reste incapable de dire quel service gère la relance de facturation.
Voici un guide pratique pour procéder dans le bon ordre : à quoi ressemble l'offre à poids ouverts aujourd'hui, comment séparer les trois demandes, ce qu'un adaptateur LoRA corrige de façon mesurable, ce que l'ensemble coûte, et comment choisir un modèle de base à partir de votre propre dépôt plutôt que du classement de quelqu'un d'autre.
Commençons par la raison de s'y intéresser. GLM-5.2, publié par Z.ai en juin 2026, est un modèle mixture-of-experts de 744 milliards de paramètres doté d'une fenêtre de contexte d'un million de tokens, avec des poids complets sur Hugging Face et une licence MIT. Il a été conçu expressément pour le code, le raisonnement et le travail agentique piloté par des outils, et il se place à environ un point de pourcentage d'Opus 4.8 d'Anthropic sur un benchmark agentique clé, pour environ un cinquième du coût. La licence MIT compte davantage que le benchmark : vous pouvez l'entraîner, le distribuer et l'héberger sans rien demander à personne.
Ce n'est pas la seule option, et la bonne base dépend de la forme de votre charge de travail. Qwen3-Coder-480B est sous Apache-2.0 et se situe autour de 69,6 % sur SWE-bench Verified, avec des variantes plus petites bien plus faciles à auto-héberger. DeepSeek-V3.2 est sous licence MIT et atteint environ 70 %. Kimi K2.6 est le choix pour le travail multimodal et multi-agents, et MiniMax M3 pour les tâches à bas coût et haut débit. En pratique, GLM-5.2 est le choix par défaut le plus solide pour le travail d'agents à long contexte et à long horizon, tandis que Qwen3-Coder est l'option retenue par la plupart des équipes quand elles ont besoin d'un modèle qui tourne sur du matériel qu'elles contrôlent.
Une mise en garde sur les chiffres : GLM-5.2 est sorti sans benchmarks indépendants publiés, présenté par son éditeur comme meilleur que les versions précédentes sur le code à long horizon. Traitez chaque chiffre de cette section comme un filtre, pas comme une décision. Ce qui nous amène à ce qui compte vraiment.
Les benchmarks filtrent, votre dépôt tranche
Prenez la décision finale avec un jeu d'évaluation privé construit à partir de vos propres tâches, exécuté sur le checkpoint quantifié exact que vous allez déployer, dans le même framework d'agents que celui que vous utiliserez en production. Un modèle en tête d'un classement en pleine précision peut se comporter très différemment en 4 bits dans votre harness.
Quand quelqu'un dit vouloir un modèle entraîné sur son code, il veut généralement trois choses différentes à la fois. Les nommer séparément représente l'essentiel du travail.
La première demande, ce sont les faits. Ce qui existe dans la base de code, où cela se trouve, quel service possède quelle table, ce que renvoie réellement cette fonction utilitaire. C'est de la connaissance, et la connaissance change : votre dépôt change tous les jours, des poids non. Graver des faits dans un checkpoint, c'est réentraîner à chaque merge. Cette demande relève de la récupération, et elle y reste définitivement. Le consensus de 2026 est sans appel : si la réponse dépend de données qui changent, utilisez la récupération, et ne faites de fine-tuning que pour des comportements qui ne doivent pas changer.
La deuxième demande, ce sont les conventions. La manière dont votre équipe fait les choses : la checklist de revue, la procédure de migration, la façon d'encapsuler les erreurs, la règle selon laquelle rien ne parle à la base de données hors d'une classe repository. Cela ressemble à un problème d'entraînement et ne l'est presque jamais. Des fichiers de skills sélectionnés, de simples instructions décrivant quand et comment faire quelque chose, donnent le même comportement instantanément, fonctionnent avec tous les fournisseurs de modèles, et peuvent être modifiés, versionnés, testés et annulés sans toucher à un checkpoint. Le fine-tuning modifie le comportement de façon permanente et il est lent et pénible à défaire ; un fichier de skill, c'est une pull request.
Il y a ici une nuance importante, et c'est l'un des résultats de recherche les plus utiles de l'année : la simple présence de skills ne garantit rien. Les skills générées automatiquement n'apportent aucun bénéfice en moyenne, celles qui sont sélectionnées et rédigées par des humains battent systématiquement la référence sans skills, et les skills de mauvaise qualité dégradent de façon mesurable les performances de l'agent. Ne pointez donc pas un modèle vers votre dépôt en lui demandant d'écrire ses propres conventions. Demandez à votre meilleur ingénieur d'en écrire dix vraies, à la main, à partir de ce qui coince réellement en revue.
La troisième demande, ce sont la forme et les schémas d'outils, et celle-ci est un véritable travail d'entraînement. Amener le modèle à émettre vos appels d'API internes avec vos noms de paramètres, à suivre exactement votre structure de sortie et à choisir de façon fiable le bon outil dans votre propre ensemble d'outils, c'est précisément ce que le fine-tuning sait bien faire. C'est de la forme, pas des faits, et c'est stable d'une manière que l'emplacement des fichiers ne l'est pas.
L'exemple publié le plus clair de la troisième demande est celui d'une équipe qui avait besoin qu'un modèle comprenne ses schémas d'outils et sa nomenclature de paramètres. Le taux de réussite des appels d'outils de son agent était de 40 %, ce que vous reconnaîtrez, si vous avez déjà livré un agent, comme le chiffre où rien ne marche et où tout le monde accuse le modèle. Après un fine-tuning QLoRA, il était à 90 %. L'exécution a coûté environ 1 500 $ tout compris sur une seule RTX 4090, et s'est placée à moins de 1 % d'un fine-tuning complet sur tous les benchmarks mesurés.
Remarquez ce qui a bougé. Ni la connaissance que le modèle avait de leur système, ni sa capacité générale à coder, mais sa conformité à leur interface. Voilà la promesse honnête d'un entraînement sur votre propre code : des agents qui cessent de se tromper avec vos outils. Si votre agent échoue aujourd'hui parce qu'il invente des noms de paramètres, renvoie des structures mal formées ou choisit le mauvais outil, un adaptateur corrigera cela. S'il échoue parce qu'il ne connaît pas votre architecture, un adaptateur n'y changera rien, et aucun entraînement non plus.
La puissance de calcul brute est désormais presque gratuite. Un fine-tuning LoRA ou QLoRA d'un modèle de 7–8B coûte 3 à 10 $ de temps GPU : deux à quatre heures sur une A100 louée, moins de 3 $ sur une 4090 que vous possédez déjà. Une exécution QLoRA sur 70B tourne autour de 15–30 $. Les services managés facturent environ 0,48–0,50 $ par million de tokens, si bien qu'une tâche typique de 50M de tokens sur un modèle de 8B revient à environ 25 $ en hébergé contre 3–10 $ en le faisant vous-même. LoRA est le bon choix dans l'immense majorité des cas, et les adaptateurs se combinent étonnamment bien : un adaptateur de style de code et un adaptateur de raisonnement sécurité n'interfèrent pratiquement pas.
La facture GPU n'est pas le vrai coût
L'entraînement coûte 10 $. Le vrai budget part dans la sélection d'exemples représentatifs de la façon dont votre équipe travaille réellement, et dans la construction du jeu d'évaluation qui vous dit si l'adaptateur a aidé. Les équipes qui sautent ces deux étapes obtiennent un modèle différent et sûr de lui plutôt que mesurablement meilleur, sans aucun moyen de savoir lequel des deux.
La séquence sur laquelle les praticiens ont convergé en 2026 est : prompt, puis récupération, puis fine-tuning, puis distillation. Et le fine-tuning au meilleur rendement est un adaptateur LoRA léger sur un modèle de base solide, associé à la récupération plutôt que la remplaçant. Chaque étape est moins chère et plus réversible que la suivante, donc travailler dans l'ordre signifie que vous découvrez souvent que vous pouvez vous arrêter tôt.
Cet ordre vous protège aussi de l'erreur la plus coûteuse ici, qui est de vous lier trop tôt à un checkpoint. La récupération vous laisse changer librement de modèle de base ; un fine-tuning, non. Vu la vitesse de ce domaine, de GLM-5.1 à 5.2 en quelques mois, vous voulez que la partie de votre système qui encode votre métier soit celle que vous pouvez porter sur un meilleur modèle de base en un après-midi.
Il y a une raison pour laquelle cette conversation tourne autour de GLM et Qwen plutôt que des API fermées. S'entraîner sur votre propre code signifie que votre code devient une donnée d'entraînement, et avec des poids sous MIT ou Apache-2.0 vous pouvez mener tout le processus dans une infrastructure que vous contrôlez, ce qui fait la différence entre une conversation avec votre équipe sécurité et une conversation avec les équipes sécurité de vos clients. Pour quiconque opère sous des engagements de résidence des données ou des conditions de traitement d'entreprise, auto-héberger une base ouverte est souvent la seule version de ce projet qui survit à la revue.
La seconde raison est la portabilité. Des poids ouverts plus un harness d'agents agnostique au modèle signifient que l'adaptateur entraîné ce trimestre peut passer sur le modèle qui dominera le trimestre prochain. C'est une position sensiblement différente de celle qui consiste à bâtir votre workflow sur le produit de fine-tuning hébergé d'un seul fournisseur en espérant que les prix tiennent.
Si vous voulez savoir si tout cela vaut votre temps, ne commencez pas par un entraînement. Commencez par déterminer laquelle des trois demandes vous coûte réellement.
Suivez cet ordre et l'une de deux choses se produira. Soit vous découvrez que l'essentiel de votre problème tenait aux faits et aux conventions, auquel cas vous l'avez résolu en une semaine avec de la récupération et des fichiers de skills, gratuitement, en sautant complètement le projet d'entraînement. Soit vous trouvez un noyau dur d'échecs d'interface qu'aucun prompt ne corrige, et vous dépensez 10 $ pour transformer un taux d'appels d'outils de 40 % en quelque chose que vous pouvez livrer. Les deux issues sont bonnes. La mauvaise, c'est celle où vous commencez par le fine-tuning, parce que c'est la partie la plus intéressante, et finissez avec un modèle qui a assez bien appris votre style maison pour s'y tromper de manière convaincante.
L'offre à poids ouverts a franchi un vrai seuil cette année : pour la première fois, un fondateur peut prendre un modèle de code de classe frontière sous licence MIT, l'adapter à ses propres interfaces pour le prix d'un café, et faire tourner l'ensemble sur du matériel qu'il contrôle. C'est un véritable changement dans ce qu'une petite équipe peut posséder. Il faut simplement se rappeler que le levier vient du fait de savoir à laquelle des trois demandes vous répondez, pas de l'entraînement lui-même.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.