Deux façons de répartir cinq agents de code : l'une en gaspille quatre, l'autre entre en conflit 41,7 % du temps

By Surya Pratap
22 septembre 2026
12 min read
AI & Technology

22 septembre 2026
12 min read
 Répartition redondante et répartition divisiveHover to explore
Une catégorie d'outils est apparue cette année sans que personne ne la baptise très fort, et ce qui est intéressant n'est pas ce qu'elle fait bien. C'est ce qu'elle vous laisse, discrètement, sur les bras.
Cet article s'appuie sur Orca, l'environnement d'agents parallèles de Stably AI sous licence MIT, et sur l'article explicatif d'ArshTechPro publié le 20 septembre 2026 ; sur le jeu de données AgenticFlict de Daniel Ogenrwot et John Businge ; sur l'étude de Xu, Subramanian et Karthik sur les pull requests concurrentes d'agents ; et sur l'analyse que Daniel Vaughan en a faite. La section 8 dit quels chiffres j'accepte, et jusqu'où. La distinction entre les deux répartitions, l'argument des coutures et toutes les recommandations sont de moi.
L'environnement de développement d'agents — ADE, et oui, on est à une lettre d'IDE exprès — est une application de bureau qui ne contient aucun modèle. Elle contient une flotte.
Orca est celle qui a percé. Licence MIT, disponible sur macOS, Windows et Linux avec une application compagnon mobile, et son propre argumentaire est direct : « Faites tourner Codex, ClaudeCode, OpenCode ou Pi côte à côte, chacun dans son worktree, suivis au même endroit. » Elle prend en charge une trentaine d'agents CLI nommément, et en pratique n'importe lequel. Quand j'ai consulté le dépôt le 22 septembre, il affichait environ 75 000 étoiles ; les revues écrites cet été citent des chiffres plus proches de 60 000, donc la courbe est assez raide pour que le nombre que vous lisez soit déjà faux.
Le mécanisme est une primitive de git présente depuis 2015 et qui trouve soudain son application phare :
Une tâche, un worktree. Chaque agent reçoit son propre répertoire de travail partageant le même dépôt d'objets : un vrai système de fichiers, une vraie branche, sans stash.
Un worktree, un terminal. La session de l'agent, ses tests et son serveur d'aperçu sont tous cantonnés à ce répertoire.
Plus de bagarre pour .git/index.lock. Le scénario où deux agents écrivent dans le même répertoire de travail et se corrompent mutuellement devient tout simplement impossible.
Des diffs annotables. On laisse des commentaires markdown sur des lignes précises du diff, on les regroupe et on les renvoie à l'agent comme retour.
C'est de la bonne ingénierie et cela règle un agacement véritable. Si vous avez déjà voulu lancer une deuxième tâche pendant qu'un agent peine sur la première, vous savez exactement quel problème est traité ici.
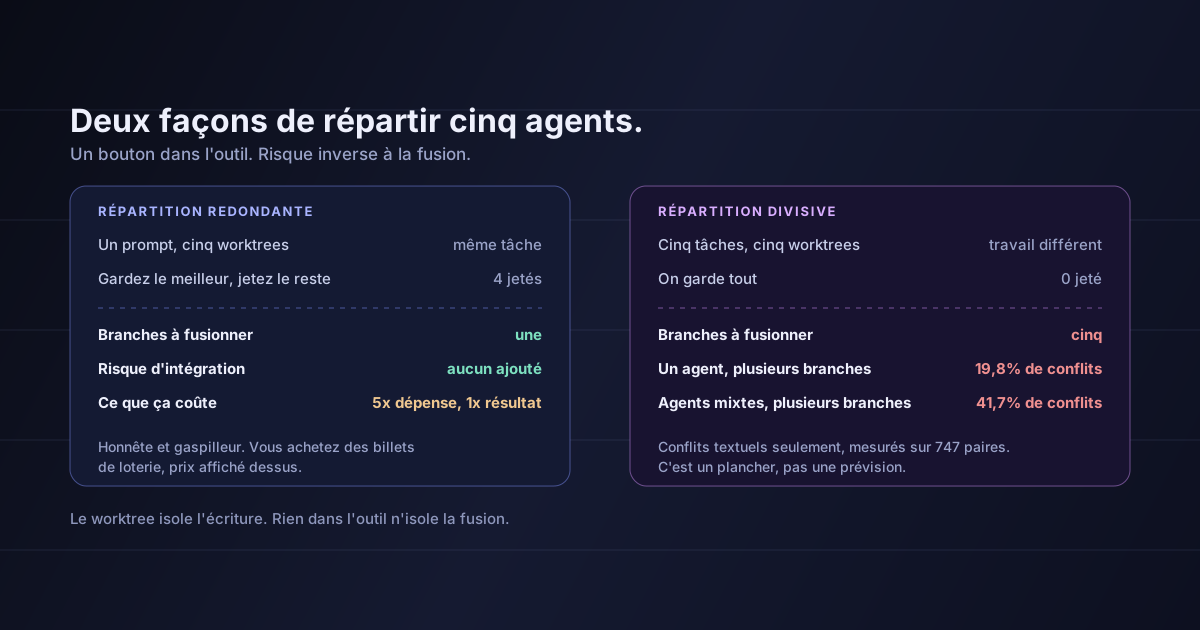
Le worktree isole l'écriture. Rien dans l'outil n'isole le merge.
Voici ce qui m'a donné envie d'écrire ceci. L'outil propose un seul geste — répartis ça sur cinq agents — et ce geste unique recouvre deux opérations totalement différentes.
La répartition redondante, c'est la démo. Un prompt, cinq agents, cinq worktrees, cinq tentatives sur la même tâche. Vous lisez les cinq diffs, gardez la meilleure et supprimez quatre branches. Le texte d'Orca le décrit ainsi : répartissez un prompt sur cinq agents, comparez les résultats, fusionnez le gagnant.
La répartition divisive, c'est ce vers quoi vous glissez. Cinq tâches différentes, cinq worktrees, cinq agents, et à la fin vous voulez les cinq. On ne jette rien, parce que jeter n'a jamais été le but : le but était de faire cinq choses dans le temps d'une.
Dans l'interface, elles se ressemblent. Ce sont des contraires.
| Répartition redondante | Répartition divisive | |
|---|---|---|
| Ce qui varie | L'agent ou la graine | La tâche |
| Branches conservées | Une | Toutes |
| Branches à fusionner | Une | Toutes |
| Risque d'intégration ajouté | Aucun | Le sujet de cet article |
| Ce que vous payez | N× la dépense pour 1× le résultat | N× la dépense pour N× le résultat, moins les conflits |
La répartition redondante est un billet de loterie honnêtement affiché. Vous dépensez cinq fois pour obtenir un résultat, et vous savez d'avance que quatre cinquièmes de la dépense partent à la poubelle. Le testeur cité dans la couverture presse le dit sans détour : faire tourner Claude Code trois fois en parallèle consomme trois fois votre quota. Il n'y a pas de coût caché, parce que le gaspillage est justement la partie visible.
C'est dans la répartition divisive que vit le coût caché. Elle paraît plus économe — on ne jette rien ! — et c'est exactement pour cela qu'on y migre, en général dans la semaine qui suit l'installation.
Trois travaux empiriques de 2026 touchent à ce point, et lus ensemble ils racontent une histoire cohérente.
À quel point le travail concurrent d'agents est-il déjà répandu ?
Xu, Subramanian et Karthik ont dépouillé 33 596 pull requests écrites par des agents dans 2 807 dépôts. Avec un chevauchement temporel strict, 79,4 % des PR d'agents étaient actives en même temps qu'une autre PR d'agent, dans 40,2 % des dépôts. En élargissant la fenêtre à une semaine, on passe à 95 % des PR dans 53,4 % des dépôts.
La répartition divisive n'est pas une pratique d'avant-garde que quelqu'un pourrait essayer. C'est l'état par défaut de tout dépôt où travaillent des agents.
À quelle fréquence ce travail entre-t-il en collision ?
Le jeu de données AgenticFlict de Daniel Ogenrwot et John Businge est le plus large : plus de 142 000 pull requests d'agents provenant de plus de 59 000 dépôts, dont plus de 107 000 rejouées par simulation déterministe de merge. Le résultat : 27,67 % — plus de 29 000 PR — ont produit des conflits textuels de merge, répartis sur plus de 336 000 régions de conflit distinctes.
La comparaison qui donne du mordant : les études antérieures sur les pull requests écrites par des humains se situent généralement entre 10 et 20 %. Les contributions d'agents entrent donc en conflit une fois et demie à deux fois et demie plus souvent.
Est-ce que l'identité des agents compte ?
Voici le résultat qui recadre le produit. Xu et ses collègues ont lancé des simulations de merge sur 747 paires de PR et les ont séparées :
La fonctionnalité phare est le pire cas
Les paires d'agents différents sont entrées en conflit environ deux fois plus que les paires d'un même agent. La capacité mise en avant par tout ADE — faites tourner Claude Code et Codex et Cursor côte à côte, pourquoi être fidèle à un seul — est, en mode divisif, la configuration que les données aiment le moins. Deux agents entraînés différemment, amorcés depuis des fichiers système différents, avec des avis différents sur le nommage, l'organisation des fichiers et l'endroit où doit vivre un utilitaire, vont diverger structurellement d'une manière que deux exécutions d'un même agent évitent le plus souvent.
À dire honnêtement : dans la nature, le chevauchement entre agents différents reste rare — seulement 0,5 % des paires concurrentes impliquaient des agents distincts, dans 122 dépôts sur 2 807. Le chiffre de 41,7 % décrit ce qui arrive si vous le faites, mesuré sur un petit échantillon. Et toute la proposition de valeur de l'ADE consiste à rendre facile ce qui était rare.
Décomposez ce que sont réellement ces conflits et le tableau cesse de parler de gestion de versions. D'après l'analyse que Vaughan fait de l'étude, les paires en conflit se répartissent en trois :
| Classe de conflit | Part | Ce que cela signifie vraiment |
|---|---|---|
| Chevauchement textuel | 57,6 % | Deux agents ont modifié les mêmes lignes. Un échec de répartition : vous avez mis deux personnes à un seul bureau |
| Modification / suppression | 26,8 % | Un agent a modifié ce que l'autre a supprimé. Une décision d'architecture que personne n'a prise, prise deux fois, différemment |
| Ajout / ajout | 15,1 % | Les deux agents ont créé le même fichier. Un échec de spécification : aucun n'a été prévenu que l'autre en aurait besoin |
Seul le premier est un problème de merge. Les deux autres — environ 42 % à eux deux — sont structurels, ne se résolvent pas mécaniquement et ne sont pas vraiment des conflits entre branches. Ce sont des conflits entre deux plans, découverts au pire moment possible : une fois les deux plans entièrement implémentés.
Un conflit ajout/ajout est particulièrement parlant. Deux agents ont conclu séparément qu'un fichier devait exister, l'ont inventé, et ni l'un ni l'autre ne savait pour l'autre. Aucun outillage de merge ne répare cela. La réparation est en amont, dans ce que vous leur avez dit.
Et notez où ces conflits atterrissent : 84,4 % des fichiers en conflit étaient du code source, pas des fichiers de verrouillage ni des manifestes de dépendances. Ce n'est pas le conflit fastidieux mais mécanique qu'on règle en prenant la version de l'autre. C'est celui où il faut comprendre les deux côtés.
C'est le passage que je soulignerais si je ne pouvais garder qu'un paragraphe.
Tous ces taux ne portent que sur les conflits textuels. Les auteurs le disent explicitement : les chiffres sont une borne inférieure conservatrice qui exclut les échecs de compilation et les conflits sémantiques. Autrement dit, ils mesurent les cas où git s'est arrêté pour vous prévenir.
Le cas dangereux est l'autre.
Le conflit qui fusionne proprement
Deux agents, deux worktrees. L'un renomme une fonction et met à jour tous les appels qu'il voit. L'autre ajoute un nouvel appel, dans un fichier que le premier n'a jamais ouvert, sous l'ancien nom. Fichiers différents. Aucune ligne en commun. Git fusionne sans broncher — et vous voilà avec une branche qui ne compile pas ou, pire, une qui compile. Changez une règle de validation dans une branche en vous appuyant sur l'ancienne règle dans l'autre : CI au vert et un bug qui remonte en production quinze jours plus tard. Il n'existe pas de marqueur de conflit pour « ces deux changements ne sont pas d'accord sur ce qui est vrai ».
Les worktrees isolent au niveau du système de fichiers. Ils ne coordonnent pas au niveau sémantique, et deux branches peuvent toucher des fichiers entièrement disjoints tout en se contredisant : via les tables de routes, les réexports groupés, les définitions de types partagées, la configuration, les schémas de base de données, ou une simple hypothèse sur le comportement de quelque chose.
La lecture honnête des 27,67 % est donc : voilà la part où le problème s'est annoncé tout seul. Personne n'a mesuré la part où il ne l'a pas fait, et elle n'est pas nulle.
Voici le recadrage sur lequel je construirais, et il ne parle pas d'outils du tout.
Tout ADE vous invite à répondre à la question combien d'agents dois-je lancer ? par un nombre tiré de votre budget ou de votre machine. Cinq, ça sonne bien. Cinq, c'est ce que montre le marketing. Mais la vraie contrainte n'a rien à voir avec le quota :
Vous pouvez lancer autant d'agents en parallèle que votre code a de coutures — des frontières de part et d'autre desquelles deux changements peuvent s'écrire sans avoir besoin de se voir.
Une couture, c'est un module à l'interface stable, un service derrière un contrat d'API, une migration qui n'ajoute que, un composant que personne d'autre n'importe. Si votre code a quatre vraies coutures, quatre agents est le plafond. En lancer huit signifie que quatre d'entre eux écrivent contre des hypothèses que les quatre autres modifient au même moment, et vous découvrirez lesquelles au merge, aux taux indiqués plus haut.
Cela explique ce qui ressemble autrement à un paradoxe : les équipes au code bien factorisé racontent que les agents parallèles marchent à merveille, celles au code emmêlé racontent le chaos, et les deux font tourner exactement le même logiciel. La variable n'est pas l'outil. C'est le nombre de coutures.
Cela donne aussi la réponse honnête à faut-il adopter ça ? Si vous avez trois coutures, acheter un gestionnaire de flotte pour douze agents, c'est acheter une capacité inutilisable. Le travail qui débloque le parallélisme est le même travail ennuyeux de modularité qu'il a toujours été — conclusion peu satisfaisante, et je la crois vraie.
Cinq choses, dans l'ordre, dont aucune ne vous demande d'abandonner un outil que vous aimez.
Vous n'avez pas besoin d'une étude ; vous avez besoin de git merge-tree. Prenez les branches produites par vos agents le mois dernier, rejouez chaque paire contre sa base de merge et comptez celles qui entrent en conflit. Ce nombre est le vôtre : il reflète la structure de coutures de votre code, pas la moyenne du secteur. S'il est nettement sous les 19,8 %, votre découpage est meilleur que la normale et vous pouvez élargir. S'il dépasse 40 %, ajouter des agents revient à ajouter de la reprise.
Une simulation de merge coûte assez peu pour tourner dans un hook à chaque fois qu'un agent écrit un fichier. Savoir que deux agents foncent vers les mêmes lignes vaut énormément à la troisième minute et presque rien à la deuxième heure, quand tous deux ont déjà construit par-dessus la collision.
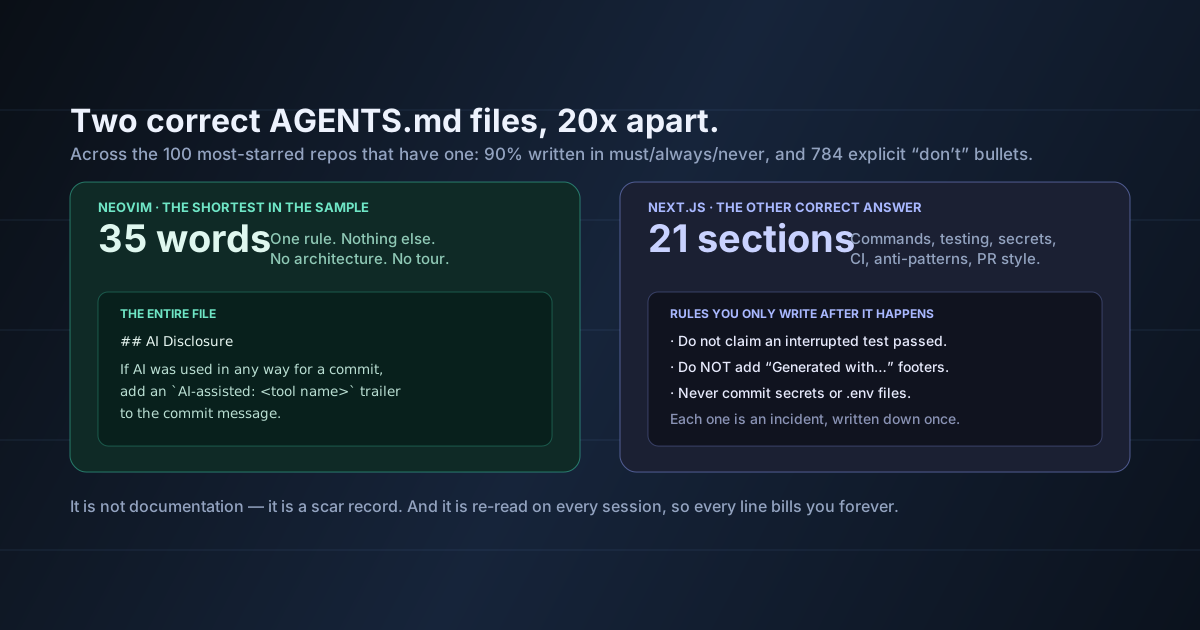
Avant une répartition, nommez les chemins que chaque tâche a le droit de toucher — et traitez un agent qui sort de son ensemble comme le signe que la tâche était mal cadrée, pas comme une broutille à laisser passer. AGENTS.md est le bon endroit pour les frontières qui valent d'une tâche à l'autre ; voyez ce que les meilleurs dépôts écrivent réellement dans le leur.
Faites atterrir une branche, rebasez la suivante sur la nouvelle base et, en cas de conflit, donnez à l'agent la base rebasée et laissez-le refaire son changement plutôt que de résoudre à la main un conflit entre deux choses que vous n'avez pas écrites. Que l'agent règle son propre travail face à la réalité actuelle vaut mieux que vous arbitriez entre deux plans auxquels vous n'avez pas participé.
19,8 % contre 41,7 %, c'est la décision la moins chère de tout cet article. Gardez la comparaison multi-agents pour la répartition redondante, là où vous choisissez un gagnant et jetez le reste : la divergence de style y est justement le but et ne vous coûte rien, puisqu'une seule branche atterrit.
La règle empirique sous ces cinq points :
Utilisez plusieurs agents quand vous ne garderez qu'un résultat, et un seul agent quand vous en garderez plusieurs. L'ADE fait des deux un clic unique, et c'est précisément pour cela que la distinction doit vivre dans votre tête.
747 paires, c'est un petit échantillon, et l'intervalle entre agents différents est large. Le chiffre de 41,7 % porte un intervalle de confiance à 95 % de 33,1 à 50,9 %. La direction — entre agents différents, c'est nettement pire — est le résultat sur lequel j'agirais. La deuxième décimale, non.
Les 27,67 % d'AgenticFlict ne sont pas une prédiction pour votre dépôt. C'est un taux de population sur 59 000 dépôts aux structures, cultures de revue et usages d'agents radicalement différents. Un code bien factorisé avec des tâches bien cadrées se situera très en dessous. C'est une raison de mesurer, pas un nombre avec lequel planifier.
La référence humaine de 10 à 20 % vient d'autres études aux méthodes différentes. Les comparer est utile pour le sens, ce n'est pas une expérience contrôlée. Les PR d'agents sont aussi typiquement plus grosses et produites plus vite, et une partie de l'écart tient sûrement à cela plutôt qu'à quoi que ce soit d'intrinsèque aux agents.
Je ne prétends pas que l'ADE est un mauvais outil. L'isolation par worktree est franchement juste, et la boucle annoter-puis-renvoyer-à-l'agent est ce que la catégorie a de meilleur. Mon propos porte sur l'écart entre ce qu'il résout et ce qu'un fondateur suppose qu'il résout, pas sur la qualité de ce qu'il fait.
Les étoiles ne sont pas de l'adoption et encore moins de la rétention. 75 000 étoiles dans une catégorie qui bouge vite vous dit que l'attention est arrivée. Cela ne dit rien du nombre de ces dépôts qui l'utiliseront encore en mars.
Rien de tout cela n'est mesuré sur les conflits sémantiques, moi non plus. J'ai soutenu qu'ils existent et que les taux publiés sous-estiment donc le problème. Je ne peux pas vous dire de combien, et personne ne le peut encore.
Faire tourner des agents de code en parallèle a cessé d'être un problème difficile cette année. Worktrees isolés, un clic, trente agents pris en charge, licence MIT, ça marche depuis le téléphone. Cette partie est terminée.
Faire atterrir ce qu'ils produisent ne l'est pas, c'est mesurablement plus dur que de faire atterrir du travail humain, et c'est la moitié qu'aucun ADE ne prétend résoudre — parce qu'elle ne peut pas l'être dans l'outil. Elle dépend de la factorisation de votre code et de la précision du cadrage de vos tâches, deux choses qui étaient votre travail avant que tout ceci n'existe.
Le schéma est celui qui ne cesse de se répéter en ingénierie agentique : le goulot d'étranglement ne disparaît pas, il se déplace, et il se déplace vers ce qui exige encore du jugement. La génération est devenue parallèle. L'intégration, non, et c'est là qu'est le jugement.
Avant d'élargir la répartition, comptez vos coutures. Si le nombre est inférieur à celui des agents que vous alliez lancer, vous n'achetez pas du débit : vous achetez des conflits de merge à un taux documenté, en payant plein tarif par agent pour ce privilège.
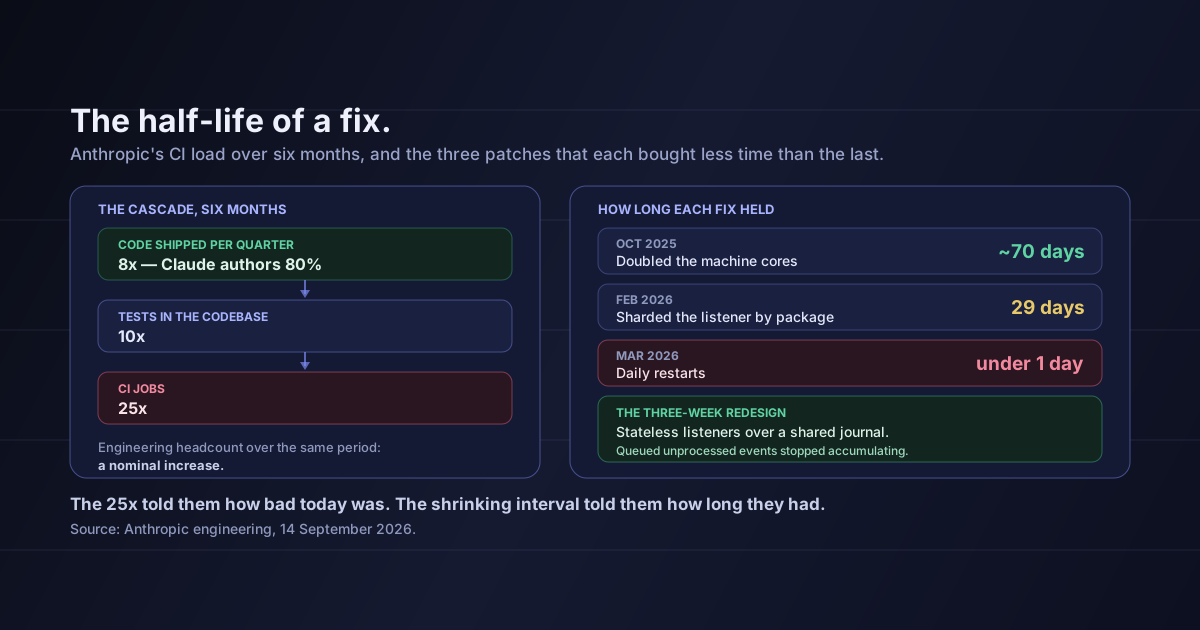
Sources : Orca sur GitHub — la licence MIT, la liste des agents pris en charge, le modèle d'isolation par worktree, la description de la répartition d'un prompt sur cinq agents et le compte d'étoiles au 22 septembre 2026. ArshTechPro, « Orca Explained », 20 septembre 2026 — le cadrage ADE, la structure worktree plus terminal plus aperçu, la boucle d'annotation des diffs et la remarque que les agents parallèles multiplient la consommation. Ogenrwot et Businge, « AgenticFlict » — les 142 000 pull requests, les 59 000 dépôts, les 107 000 simulations de merge, le taux de 27,67 % de conflits textuels, les 336 000 régions de conflit et la référence humaine de 10 à 20 % issue de travaux antérieurs. Xu, Subramanian et Karthik, « AI Agent Pull Requests on GitHub » — les 33 596 PR dans 2 807 dépôts, les chiffres de concurrence de 79,4 % et 95 %, la simulation sur 747 paires, les taux de 19,8 % et 41,7 % avec leurs intervalles de confiance, les 0,5 % de paires entre agents différents et les 84,4 % de fichiers de code source. Daniel Vaughan, « When Agents Collide », 28 juillet 2026 — la taxonomie 57,6 % / 26,8 % / 15,1 % et l'observation que l'isolation par worktree évite les collisions de répertoire mais pas les conflits de merge. La distinction entre répartition redondante et divisive, la correspondance entre les classes de conflit de git et les échecs de répartition, d'architecture et de spécification, l'argument des coutures et toutes les recommandations de la section 7 sont de moi. Pour l'argument du goulot qui se déplace, voyez les chiffres de CI d'Anthropic, et sur qui devrait relire tout ce travail, recrutez le relecteur avant le développeur.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.