Microsoft a fait travailler 1 024 agents de code sans chef. 128 fois plus d'agents ont rapporté 9,5 points

By Surya Pratap
29 septembre 2026
9 min read
AI & Technology

29 septembre 2026
9 min read
 Plus d'agents, surtout plus tôtHover to explore
La façon habituelle de faire travailler beaucoup d'agents de code consiste à en mettre un aux commandes : un planificateur découpe le travail et le distribue. Ce planificateur devient le goulot d'étranglement dès qu'il y a plus de travailleurs qu'il ne peut en suivre. Un article de Microsoft Research paru la semaine dernière le supprime entièrement et pousse le résultat jusqu'à 1 024 agents. La conception mérite d'être étudiée. Les chiffres mis en avant demandent une lecture attentive.
Tout ce qui suit provient de « Agensh: Scaling Organizational Intelligence to 1,024 Agents », de Zhihao Zhan, Ting Song, Li Dong, Shaohan Huang, Jianxun Lian, Yan Xia et Furu Wei, de Microsoft Research, publié sur arXiv le 22 septembre 2026. C'est une prépublication qui n'a pas été relue par des pairs. L'interprétation, à partir de la section 3, est la mienne.
ProgramBench donne à un agent un programme compilé et lui demande de reconstruire le logiciel à partir de zéro — un code complet qui compile et se comporte de la même façon — en six heures, sans accès à Internet. Le score est la part des tests cachés que réussit le programme reconstruit.
Agensh a été testé sur les cinq tâches les plus difficiles parmi les 200 de ProgramBench, choisies d'après les mauvais résultats qu'y obtiennent les modèles actuels. Elles couvrent le traitement multimédia, la simulation moléculaire, la conversion de documents, l'interprétation de langages et l'indexation de code. Tous les travailleurs utilisaient le même modèle, GPT-5.6-sol avec un effort de raisonnement élevé.
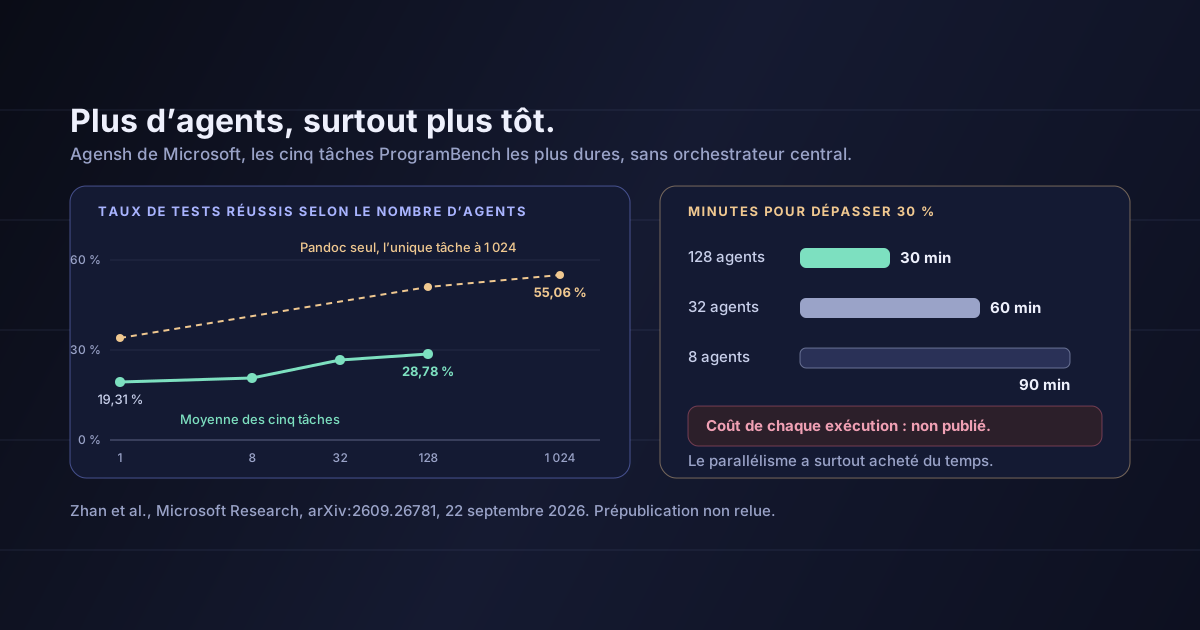
Taux moyen de tests réussis sur les cinq tâches :
| Agents | Taux moyen de tests réussis | Écart avec la ligne précédente |
|---|---|---|
| 1 | 19,31 % | — |
| 8 | 20,68 % | +1,37 point |
| 32 | 26,52 % | +5,84 points |
| 128 | 28,78 % | +2,26 points |
De 1 à 128 agents, cela fait environ 9,5 points, ce que les auteurs décrivent comme une amélioration relative d'environ 49 %.
Une seule tâche, le convertisseur de documents pandoc, a été lancée avec les 1 024 agents :
Huit fois plus d'agents que dans l'exécution à 128 ont ajouté environ 4 points sur la seule tâche où cela a été essayé.
La courbe monte. Elle monte lentement, et chaque étape coûte beaucoup plus d'agents que la précédente.
Le chiffre le plus concret de l'article n'est pas le score final. C'est la vitesse à laquelle chaque configuration est arrivée à quelque chose d'utile. Les auteurs indiquent que 128 agents ont dépassé un taux de tests réussis de 30 % au bout de 30 minutes. Avec 32 agents, il a fallu 60 minutes, et avec 8, 90.
C'est ce que le parallélisme achète de façon fiable : atteindre plus tôt un niveau donné. Le plafond a bougé aussi, mais modestement. Le temps pour atteindre un niveau exploitable a beaucoup bougé.
Pour un fondateur, la distinction compte. Si ce que vous payez, c'est un délai plus court pour un travail que vous pourriez sinon attendre, ajouter des agents revient à acheter de la latence, et cela se chiffre. Si vous espérez que davantage d'agents résolvent des problèmes qu'un seul agent ne sait pas résoudre, cet article suggère que l'effet existe, mais qu'il est faible au regard du nombre d'agents ajoutés.
La conception est la partie qui mérite d'être copiée, et elle est plus simple que ne le laisse penser l'échelle. Elle repose sur trois éléments partagés :
Un espace de travail partagé. Un serveur git. Chaque travailleur a sa propre copie et sa branche, et fusionne dans une branche principale. Git enregistre qui a modifié quoi et détecte les conflits de fusion. Si une fusion est bloquée, le travailleur récupère le travail le plus récent des autres, résout le conflit et fusionne à nouveau.
Une interface de messages. Des canaux partagés par tâche et des messages directs, livrés de façon asynchrone avec historique, pour que les travailleurs règlent qui s'occupe de quoi et démêlent les dépendances.
Un contexte partagé. Un journal en ajout seul d'entrées typées — OBSERVED, FACT, FAIL, CLAIM, PATCH_SUMMARY — dans lequel tout travailleur peut chercher. Avant de commencer, un travailleur publie un CLAIM qui décrit le périmètre qu'il prend.
Chaque travailleur suit la même boucle : lire le contexte partagé, revendiquer une partie du travail, la réaliser, la vérifier par rapport aux critères d'acceptation de cette partie, fusionner, puis publier ce qui a changé et pourquoi. Il n'y a pas de verrous. Les chevauchements se règlent par les revendications et la discussion.
Un détail montre où se situe le vrai coût de la coordination. Pour limiter les conflits sur qui s'occupe de quoi, les auteurs n'ont pas démarré tous les agents en même temps. Ils en ont lancé un toutes les 30 secondes pendant la première heure, puis un toutes les 3 secondes. Même avec une conception entièrement fondée sur l'auto-organisation, il a fallu gérer les arrivées.
Les auteurs décrivent aussi des comportements apparus à mesure que le groupe grandissait : à 8 agents, les travailleurs se sont mis d'accord sur une interface puis l'ont implémentée chacun de leur côté ; à 128, ils ont choisi leurs relecteurs en fonction de qui avait travaillé sur du code voisin ; à 1 024, plusieurs travailleurs ont pris le rôle d'intégrateurs, et d'autres ont repris des tâches abandonnées.
L'article ne publie le coût d'aucune de ces exécutions : ni total de tokens, ni dépense d'API, ni calcul par point gagné. Il donne les limites par travailleur — jusqu'à 272 000 tokens en entrée et 128 000 en sortie — et un budget de six heures, rien de plus.
C'est important, car l'affirmation sur le passage à l'échelle est en réalité une affirmation sur le prix. « 128 fois plus d'agents pour 9,5 points » n'est une bonne affaire que si l'on sait ce que coûtent 128 fois plus d'agents. Sans cela, les résultats montrent que davantage d'agents peuvent aider, pas qu'ils en valent la peine. Je ne vais pas estimer le coût à partir des limites de tokens. Les travailleurs n'utilisent pas forcément toute leur allocation, et une estimation paraîtrait plus précise qu'elle ne l'est.
La question à poser à tout résultat de passage à l'échelle d'agents
Non pas « le score a-t-il monté ? », mais « combien de points par dollar à chaque étape, et combien de minutes gagnées ? ». Ce sont les deux chiffres qui décident si le prochain doublement vaut d'être acheté.
Il n'est pas nécessaire d'avoir 1 024 agents pour utiliser cette conception. L'essentiel est utile dès qu'on en fait tourner plus d'un.
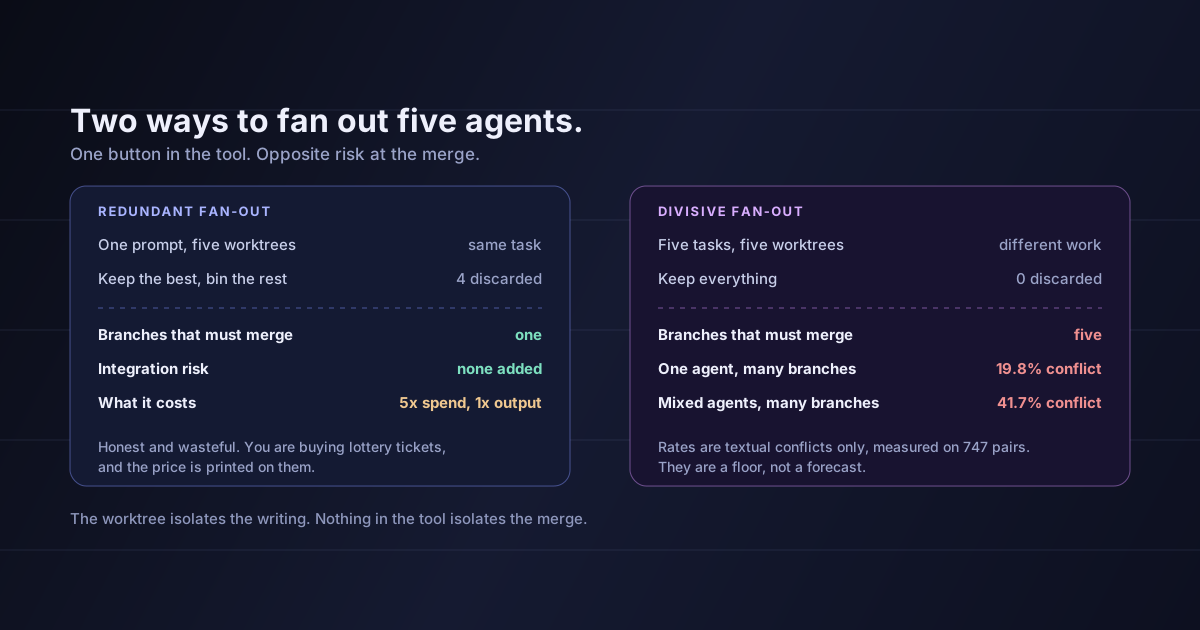
Chaque agent note ce qu'il prend avant de commencer. Notre analyse précédente sur la répartition du travail entre cinq agents de code concluait qu'isoler les agents est la partie facile et que c'est en intégrant leur travail qu'ils entrent en collision : une étude de 2026 a relevé des conflits de fusion textuels sur 27,67 % des pull requests d'agents. Une revendication visible, faite avant le début du travail, est le moyen le moins coûteux de réduire à la fois les collisions et le travail en double.
Une entrée FAIL évite à chaque agent suivant de refaire une impasse. C'est la ligne la plus précieuse du journal, et celle que la plupart des configurations n'enregistrent pas.
Des branches privées, une branche principale, et chaque conflit résolu par l'agent qui l'a provoqué. Vous avez déjà cette infrastructure, et elle enregistre déjà qui a fait quoi.
Les travailleurs d'Agensh vérifient leur travail par rapport aux critères de la sous-tâche avant de fusionner. Sans eux, « terminé » veut dire ce que l'agent décide.
Si Microsoft a dû espacer les démarrages à cette échelle, cinq agents qui lisent en même temps la même liste de tâches vide entreront eux aussi en collision. Un court délai entre les démarrages ne coûte rien.
Notez combien de temps il faut pour atteindre « assez bien » avec 1, 2 et 4 agents sur votre propre travail. Avec le coût, c'est ce qui vous dit où arrêter d'ajouter des agents.
C'est une prépublication. Elle n'a pas été relue par des pairs, et les résultats viennent d'une seule équipe sur un seul banc d'essai.
Ce sont cinq tâches et un seul modèle. Et une seule tâche a été lancée avec 1 024 agents. Le schéma peut ne pas tenir pour d'autres tâches ou d'autres modèles.
Il n'y a pas de comparaison avec un orchestrateur. L'article soutient qu'un orchestrateur central limite la coopération, mais ne compare pas Agensh à un système orchestré sur les mêmes tâches. On ne sait pas, d'après cet article, si c'est la suppression du chef qui a produit les gains.
Je n'ai trouvé aucune mesure de variance. Je ne peux pas vérifier, avec ce qui est publié, si le passage de 32 à 128 agents dépasse le bruit d'une exécution à l'autre.
ProgramBench dispose d'un corrigé exceptionnellement clair. Les agents peuvent exécuter le programme de référence et comparer les sorties à tout moment. La plupart des travaux logiciels réels n'ont pas un tel oracle, et la vérification y est bien plus difficile. La conception pourrait moins bien passer à l'échelle quand « correct » relève du jugement.
Le coût est inconnu. La section 5 déplore des données manquantes ; elle ne conclut pas que les gains sont trop chers.
Agensh montre que des agents de code peuvent se coordonner à une échelle où un chef central serait débordé, avec une infrastructure que la plupart des équipes possèdent déjà : git, un canal de messages et un journal partagé. Cette conception est utile à cinq agents, et l'essentiel s'adopte gratuitement.
Le résultat du passage à l'échelle est plus modeste que son titre. Passer de 1 agent à 128 a ajouté environ 9,5 points sur les tâches les plus difficiles. Passer de 128 à 1 024 en a ajouté environ 4 sur la seule tâche où cela a été essayé. Le gain le plus net a été la vitesse. Et l'article laisse de côté le seul chiffre qui dirait si tout cela vaut d'être payé.
Copiez cette semaine le journal des revendications et celui des échecs. Avant d'ajouter des agents, mesurez ce que chacun rapporte, en minutes et en argent.
Source : Zhihao Zhan, Ting Song, Li Dong, Shaohan Huang, Jianxun Lian, Yan Xia et Furu Wei, « Agensh: Scaling Organizational Intelligence to 1,024 Agents », Microsoft Research, arXiv:2609.26781v1, 22 septembre 2026 — la configuration de ProgramBench, la sélection des cinq tâches, le modèle et les limites de tokens, les taux moyens de tests réussis de 19,31 %, 20,68 %, 26,52 % et 28,78 %, les chiffres de pandoc de 33,89 %, 50,94 % et 55,06 %, l'amélioration relative d'environ 49 %, les délais de 30, 60 et 90 minutes pour atteindre le seuil, les trois composants de l'infrastructure et les entrées typées du contexte, le calendrier de démarrage échelonné et les comportements émergents, tels que publiés. Les écarts en points de la section 2 sont mes propres calculs à partir de ces chiffres. Les interprétations des sections 3 à 6 sont les miennes. Sur la question préalable de la répartition du travail entre quelques agents de code, voir deux façons de répartir le travail entre cinq agents de code. Sur les raisons pour lesquelles un agent qui lit tout coûte plus cher qu'il n'y paraît, voir chaque fichier lu par votre agent reste sur la facture.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.