Los encuestados de IA dijeron que el 98% sabía la respuesta. Las personas reales, el 52%. No valides tu startup con usuarios sintéticos

By Surya Pratap
1 de octubre de 2026
9 min read
MVP Strategy

1 de octubre de 2026
9 min read
 Seguros, moderados y equivocadosHover to explore
Cada vez más fundadores validan ideas sin hablar con nadie. Describen a su cliente objetivo a un modelo de lenguaje, generan unos cientos de «usuarios sintéticos» y les preguntan si comprarían. Las respuestas llegan rápido, baratas y seguras de sí mismas. Pew Research acaba de poner a prueba esa misma idea con personas reales, con cuidado, y el problema es precisamente esa seguridad.
Las cifras proceden de dos informes del Pew Research Center publicados el 30 de septiembre de 2026 por Athena Chapekis, Arnold Lau, Samuel Bestvater, Sono Shah, Andrew Mercer y Aaron Smith: «Can AI stand in for human survey takers? Not really» y «How synthetic polling results change based on the AI model». Pew estudió encuestas de opinión pública, no investigación de producto. Aplicar los resultados al trabajo de los fundadores es lectura mía, a partir de la sección 3.
Pew gestiona el American Trends Panel, un panel amplio de adultos estadounidenses reales a los que encuesta de forma repetida. Para este estudio creó un «gemelo digital» de cada miembro del panel: se dieron a un modelo de IA los datos demográficos de esa persona y sus respuestas a una encuesta anterior de tipología política, y se le pidió que respondiera encuestas nuevas como lo haría esa persona.
Los gemelos respondieron tres encuestas reales de principios de 2026, unas 300 preguntas en total, con la misma redacción e instrucciones que los humanos. Después, Pew comparó sus respuestas con las de las personas reales. El modelo principal fue Claude Opus 4.6, de Anthropic. Un segundo informe repitió el ejercicio con GPT-5.1, de OpenAI.
Es casi el mejor escenario posible para los encuestados sintéticos. Cada gemelo se construyó a partir de las propias respuestas detalladas de una persona real, no de una breve descripción de un perfil.
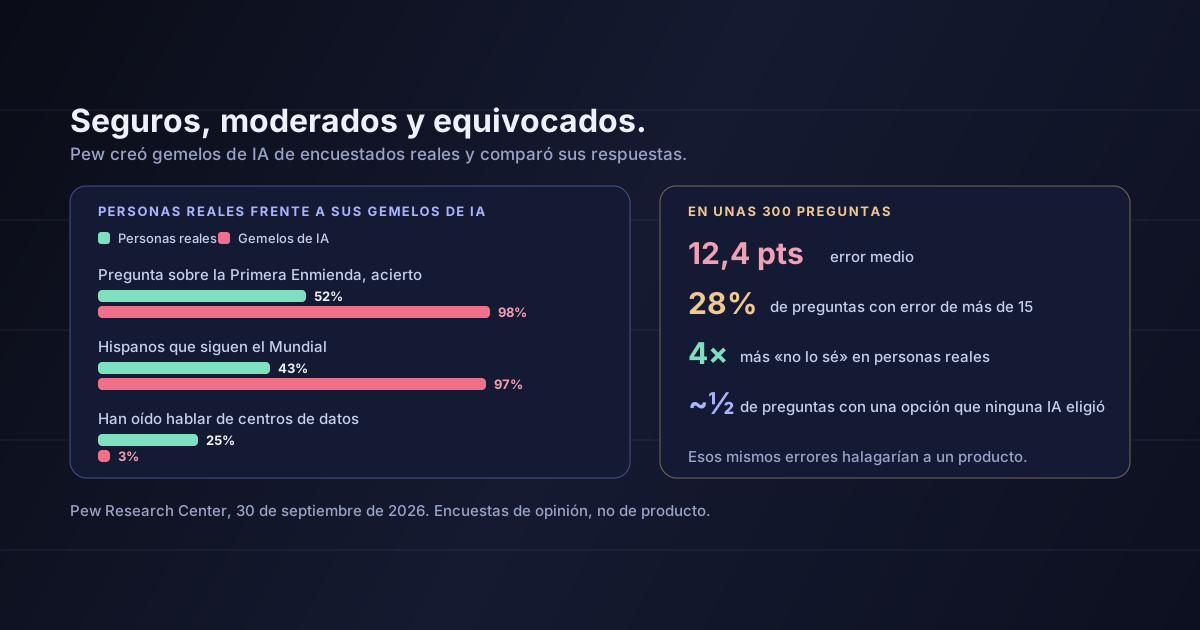
En las tres encuestas, las respuestas de la IA se desviaron de las reales 12,4 puntos porcentuales de media. En alrededor del 28% de las preguntas el error superó los 15 puntos, y eran habituales diferencias de 20 a 40 puntos en respuestas concretas.
Algunos ejemplos muestran la forma de los errores:
La conclusión de Pew: los modelos de IA «no son un sustituto adecuado» de encuestar a personas reales sobre temas de amplio interés, y sus resultados «difieren de formas a menudo impredecibles».
Los gemelos se construyeron con las propias respuestas de las personas reales y, aun así, discrepaban de ellas doce puntos de media.
Pew encontró patrones constantes en cómo se equivocaba la IA. Cada uno se corresponde con algo que los fundadores se ven tentados a preguntar a usuarios sintéticos.
Saben demasiado. Los gemelos de IA acertaron las preguntas de conocimiento mucho más que las personas reales: el 98% frente al 52% en una de ellas. Un cliente sintético entenderá tu categoría, tu jerga y tu propuesta de valor. La mayoría de tus clientes reales no, y en esa diferencia es donde fracasan los productos.
Casi nunca dudan. Las personas reales eligieron «no lo sé» unas cuatro veces más que la IA. En la investigación de clientes, «no sé, nunca lo he pensado» suele ser la respuesta más importante que puedes obtener. Los usuarios sintéticos casi nunca la dan.
Se saltan los extremos. En casi la mitad de las preguntas, al menos una opción de respuesta no la eligió ni un solo encuestado de IA. Quienes nunca comprarían y el pequeño grupo que compraría mañana son justo los que una muestra sintética deja fuera.
Interpretan el estereotipo. Los gemelos de IA respondieron como la caricatura de su grupo: el 97% de los gemelos hispanos seguía el Mundial frente al 43% real, y el 95% de los gemelos republicanos veía con buenos ojos a Israel frente al 58% real. Describe a tu cliente ideal y el modelo responderá como el tópico de ese cliente.
El quinto fallo es el que más importa para cualquier cosa nueva. Los mayores errores se dieron en acontecimientos recientes —la pregunta sobre centros de datos falló por 22 puntos—, aunque el modelo tenía acceso a tendencias anteriores. Una categoría de producto nueva es, por definición, algo con lo que las personas reales aún no se han encontrado. Es justo la situación en la que las respuestas sintéticas son menos fiables.
El segundo informe de Pew ejecutó los mismos gemelos digitales con dos modelos distintos. Discreparon entre sí tanto como con la realidad.
Un modelo volvió moderados a todos. El otro, extremos. El resumen de Pew: cada muestra sintética «pintó un retrato muy distinto del público estadounidense», y «ninguna reflejó de verdad la opinión pública real».
Para un fundador, esto significa que el «mercado» que describe un estudio con usuarios sintéticos depende en parte del modelo que uses. Cambia de modelo y se moverá tu curva de disposición a pagar.
Pew no dice que la IA no sirva para la investigación. Señala dos usos en los que ayuda: clasificar las respuestas reales a preguntas abiertas y escribir el código para analizar los resultados. En ambos, la IA procesa lo que dijeron personas reales en lugar de inventarlo.
Para los fundadores, la misma regla da una lista útil:
Pide a un modelo que te sugiera preguntas y luego quita las que inducen la respuesta. Es rápido, y nada de lo que produce se toma como prueba.
Pasa tu encuesta por un modelo para detectar preguntas confusas o dobles antes de que la vean personas reales.
Simula a un comprador escéptico para practicar tu discurso. Trátalo como un entrenamiento, no como una previsión de lo que dirán los compradores.
Después de hablar con personas reales, usa un modelo para etiquetar los temas de tus notas. Es el uso que respalda Pew.
Lo que no puede hacer es decirte si la gente quiere lo que estás construyendo, cuánta gente, ni cuánto pagaría.
Cinco conversaciones reales con personas que tienen el problema te dirán más que quinientas sintéticas, porque pueden sorprenderte. Pueden decir «no lo sé», «nunca había oído hablar de eso» o «eso lo resolvimos con una hoja de cálculo hace años»: justo las respuestas que, según Pew, la IA casi nunca da.
Si nunca has organizado esas conversaciones, nuestras guías sobre cómo preparar una llamada de descubrimiento y sobre cómo convertir el interés de una comunidad en un primer cliente de pago explican cómo hacerlo.
Pew estudió opinión pública, no demanda de producto. Las preguntas eran sobre política, actualidad y conocimientos. Aplico los patrones a la investigación de clientes porque el mecanismo es el mismo, pero Pew no probó preguntas sobre productos.
Se compararon dos modelos. Claude Opus 4.6 fue el modelo principal, y la comparación añadió GPT-5.1. La cifra principal de 12,4 puntos es la media de tres encuestas; la comparación entre modelos da 11,4 puntos para Claude y 13,3 para GPT en las preguntas que cubrió. Otros modelos, prompts o métodos podrían hacerlo mejor o peor.
Mejores métodos podrían reducir la diferencia. Lo dice la propia Pew: modelos más nuevos y nuevas formas de construir muestras sintéticas podrían dar errores menores. Es una medición del presente, no un límite permanente.
Tus usuarios sintéticos probablemente se basan en menos información. Los gemelos de Pew se construyeron con las propias respuestas detalladas de cada persona. La mayoría de los perfiles que crean los fundadores son un párrafo de descripción. Eso sugiere que los usuarios sintéticos de un fundador lo harían peor, pero es una inferencia mía, no algo que Pew haya probado.
Pew construyó la versión más cuidadosa de encuestados sintéticos que la mayoría de los fundadores podría esperar —gemelos de IA de personas reales, creados con sus propias respuestas— y aun así se desviaron unos 12 puntos de media. Sabían más que las personas reales, estaban más seguros que ellas, evitaban los extremos y respondían como el estereotipo de su grupo. Les fue peor con los temas nuevos. Y cambiar de modelo cambió el retrato.
Para una startup, eso no son casos raros. Son exactamente los errores que harían que un producto pareciera más deseado, mejor entendido y con un atractivo más amplio de lo que realmente tiene.
Usa la IA para preparar las conversaciones con clientes y para analizarlas. No para sustituirlas.
Fuentes: Athena Chapekis, Arnold Lau, Samuel Bestvater, Sono Shah, Andrew Mercer y Aaron Smith, «Can AI stand in for human survey takers? Not really», Pew Research Center, 30 de septiembre de 2026: el método de gemelos digitales, las tres encuestas del American Trends Panel de principios de 2026 y sus unas 300 preguntas, el error medio de 12,4 puntos, la proporción de preguntas con más de 15 puntos, los ejemplos de centros de datos, Primera Enmienda, OTAN y Mundial, la diferencia de cuatro veces en «no lo sé», las opciones que ningún encuestado de IA eligió, los ejemplos de estereotipos y las conclusiones de Pew sobre lo que la IA puede y no puede hacer. Los mismos autores, «How synthetic polling results change based on the AI model», Pew Research Center, 30 de septiembre de 2026: la comparación entre Claude Opus 4.6 y GPT-5.1, los errores de 11,4 y 13,3 puntos, las tasas de opción intermedia, los ejemplos de discrepancia entre modelos y la salvedad sobre métodos futuros. Las citas se reproducen aquí traducidas. La aplicación a la investigación de clientes de las secciones 3 a 6 es mía.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.