Un modelo de programación de propósito general sabe escribir React y Python como los escribe la internet abierta. No conoce los límites de módulo de tu monorepo, tu framework interno de RPC, el wrapper de autenticación que se supone que usa cada servicio ni el hecho de que tu equipo prohibió un patrón hace tres años tras una caída. Esa brecha, entre cómo programa el mundo y cómo programa tu empresa, es justo la que cierra un modelo con fine-tuning. Y en 2026, construir el stack para conseguirlo es mucho más asequible de lo que suponen la mayoría de los responsables de ingeniería.
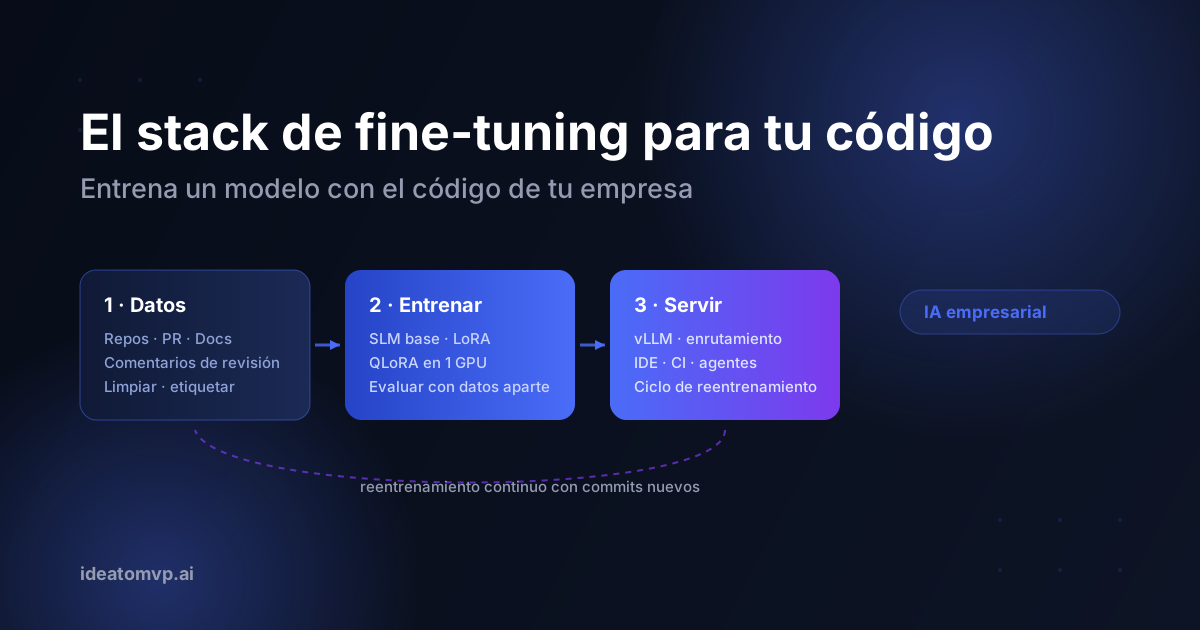
Este es un recorrido práctico, capa por capa, del stack que necesitas para hacer fine-tuning de un modelo con una base de código empresarial concreta: el pipeline de datos, la elección del modelo base, la capa de entrenamiento, la evaluación, el servicio y el ciclo de reentrenamiento que mantiene el modelo al día a medida que evoluciona tu código. También cubre la decisión que va primero: si deberías hacer fine-tuning o si la recuperación por sí sola bastará.
Primero: fine-tuning frente a RAG frente a contexto largo
Antes de reservar una sola GPU, sé honesto sobre qué problema estás resolviendo. Aquí compiten tres herramientas, y no son intercambiables:
- La recuperación (RAG) enseña hechos. «¿Qué hace esta función? ¿Dónde está definido el cliente de pagos?». Si lo que necesitas es fundamentar las respuestas en el código y la documentación actuales, RAG sobre un índice vectorial de tu repositorio es más barato, más rápido de lanzar y se actualiza en el momento en que cambia el código. Empieza por aquí.
- El fine-tuning enseña comportamiento y estilo. «Escribe código como lo escribimos nosotros». Las convenciones de nombres, los modismos de manejo de errores, las bibliotecas preferidas, la estructura de la casa para un servicio: patrones demasiado difusos para meterlos en un prompt y demasiado consistentes para dejarlos en manos de un modelo genérico. En esto el fine-tuning es único.
- El contexto largo resuelve lo puntual. Para una única tarea grande, pegar los archivos relevantes en la ventana de contexto de un modelo frontera suele bastar. No escala a cada desarrollador, cada día, con un coste predecible, y precisamente por eso los equipos acaban pasando al fine-tuning.
La respuesta madura suele ser fine-tuning más RAG: un modelo que ha interiorizado tu estilo y tus convenciones y que recupera tu código actual en el momento de la inferencia para que sus datos nunca estén desfasados. El resto de esta guía construye hacia esa combinación.
Capa 1: el pipeline de datos (el 80% del trabajo)
Cualquier profesional honesto te dirá lo mismo: el modelo es lo fácil; el proyecto son los datos. Un fine-tuning es tan bueno como los ejemplos de los que aprende, y una base de código empresarial es una fuente desordenada. El pipeline tiene cuatro etapas.
- Reunir. Toma las fuentes que de verdad reflejan cómo construye tu equipo: los repositorios de código, los pull requests fusionados y sus comentarios de revisión, los documentos internos de diseño y los ADR, los tickets resueltos y los runbooks. Los PR y los hilos de revisión son oro: capturan no solo el código, sino el razonamiento y las correcciones.
- Limpiar y filtrar. Elimina secretos y credenciales (innegociable, y hazlo antes de que nada toque un servidor de entrenamiento), quita el código generado, las dependencias incluidas en el repo y los lockfiles, descarta los módulos muertos y obsoletos, y deduplica los archivos casi idénticos para que el código repetitivo no domine la señal.
- Dar forma a los ejemplos. Decide el formato de la tarea. Para un modelo de autocompletado, usa ejemplos fill-in-the-middle (FIM) sacados de archivos reales. Para un asistente que sigue instrucciones, construye pares instrucción–respuesta: «Añade un endpoint paginado a este servicio» emparejado con el diff real que lo hizo. El título y la descripción del PR como instrucción, y el diff fusionado como respuesta, son una fuente potente y casi gratuita de datos de instrucciones.
- Separar y reservar. Reserva un conjunto de prueba antes de entrenar, idealmente con los commits más recientes, para que tu evaluación imite el uso real: predecir código que el modelo nunca ha visto. No dejes nunca que los archivos de prueba se filtren al entrenamiento.
La barrera de licencias y privacidad
Tus datos de entrenamiento son tu propiedad intelectual más sensible. Esa es la principal razón para ejecutar todo el stack en infraestructura que controlas: una VPC privada, GPU reservadas o en tus propias instalaciones. Confirma que tienes derecho a entrenar con cada fuente (vigila el código de terceros y con licencia copyleft dentro del monorepo), elimina los datos personales y los secretos, y registra exactamente qué entró en cada ejecución de entrenamiento. Cuando el stack es tuyo, esto se convierte en una propiedad de la arquitectura y no en una promesa del proveedor.
Capa 2: elegir el modelo base
No vas a entrenar un modelo desde cero: vas a adaptar una base sólida de pesos abiertos que ya entiende de programación. Elige entre la generación actual de modelos abiertos de código (las familias Qwen-Coder, Code Llama, DeepSeek-Coder y StarCoder, además de modelos generales pequeños como Phi y Gemma). Tres factores guían la elección:
- Tamaño frente a la tarea. Para el autocompletado en línea y tareas acotadas de asistente, un modelo de 3B–8B ajustado con tu código es rápido, barato de servir y a menudo supera a un modelo genérico mucho más grande en tus patrones concretos. Reserva los de 14B–34B para un razonamiento real entre varios archivos. Más grande no es el objetivo; el encaje sí.
- Licencia. Confirma que los pesos permiten el uso comercial e interno. Es una casilla legal, no un detalle: despéjala antes de construir sobre una base.
- Longitud de contexto y soporte de FIM. Las tareas de código abarcan varios archivos, así que da preferencia a bases con contexto largo y entrenamiento nativo fill-in-the-middle si tu caso de uso es el autocompletado.
Capa 3: la capa de entrenamiento (LoRA / QLoRA)
Casi con toda seguridad no necesitas un fine-tuning completo. Los métodos eficientes en parámetros, LoRA y su primo cuantizado QLoRA, entrenan un pequeño conjunto de pesos adaptadores sobre una base congelada, lo que significa que puedes adaptar un modelo de 7B en una sola GPU moderna en horas, por lo que cuesta una buena cena. Las herramientas están maduras: bibliotecas como Hugging Face PEFT, Axolotl y Unsloth envuelven todo el ciclo.
Lo que de verdad importa en esta capa:
- Los adaptadores lo mantienen modular. Como un adaptador LoRA es un archivo pequeño separado de los pesos base, puedes entrenar un adaptador por equipo, por lenguaje o por servicio, e intercambiarlos en el momento de servir. Reentrenar es barato y el radio de impacto es pequeño.
- Protégete del olvido catastrófico. Sobreentrenar con una base de código estrecha puede empeorar al modelo en programación general. Mezcla una porción de datos de código de propósito general, mantén tasas de aprendizaje moderadas y detente pronto según tu curva de evaluación, no según un número fijo de épocas.
- Registra cada ejecución. Versiona juntos el conjunto de datos, el modelo base, los hiperparámetros y el adaptador resultante. Cuando un modelo empeore, necesitas saber exactamente qué cambió.
En cuanto a la capacidad de cómputo: alquila antes de comprar. Una GPU reservada en la nube (una A100 o H100 de CoreWeave, Lambda o el nivel reservado de un hiperescalador) es el punto de entrada correcto. Pasa a hardware propio solo cuando el volumen de entrenamiento e inferencia sea lo bastante estable como para justificarlo.
Capa 4: la evaluación (la capa que los equipos se saltan y lamentan)
Un fine-tuning que «parece mejor» en una demo no es un resultado. La diferencia entre un programa de modelos en producción y un proyecto de ciencias es un arnés de evaluación real que se ejecuta en cada reentrenamiento. Para el código tienes opciones inusualmente buenas:
- Pruebas basadas en ejecución. El código se puede comprobar. Genera completados para tareas reservadas, ejecútalos contra tus pruebas unitarias reales y mide cuántos pasan. Construye un conjunto interno al estilo de SWE-bench a partir de tus propias incidencias resueltas y sus pruebas: es la señal más honesta que puedes conseguir.
- Comprobaciones de estilo y convenciones. Pasa el código generado por tus linters, formateadores y comprobadores de tipos. Un modelo que ha interiorizado tus convenciones produce código que supera limpiamente tus barreras de CI.
- Cara a cara con la referencia. Compara siempre el fine-tuning con el modelo base sin ajustar y con una API frontera potente en la misma tarea. Si no supera a ambos en tu métrica, has aprendido algo valioso antes de lanzarlo.
Capa 5: el servicio y la capa de aplicación
Un adaptador entrenado guardado en un almacenamiento de objetos no ayuda a nadie. La capa de servicio es donde el modelo se encuentra con los desarrolladores:
- Servidor de inferencia. Sirve con vLLM, TGI u Ollama para una inferencia de alto rendimiento y baja latencia, crítica para el autocompletado, donde cualquier cosa por encima de un par de cientos de milisegundos parece rota. Cuantiza (GPTQ/AWQ) para meter más concurrencia en cada GPU.
- Recuperación en el momento de la inferencia. Combina el modelo ajustado con RAG sobre tu repositorio actual para que tenga el estilo incorporado y los datos al día en el contexto. Esta es la recompensa del fine-tuning más RAG.
- Superficie de entrega. Ponlo donde los desarrolladores ya trabajan: una extensión del IDE para el autocompletado, un endpoint de chat para preguntas, un bot de CI para la revisión o como herramienta dentro de un flujo de trabajo agéntico.
- Enrutamiento. No tienes que servir cada petición desde tu modelo. Envía a tu fine-tuning las peticiones de alto volumen y propias del dominio, y escala a una API frontera las raras, de verdad difíciles y abiertas. Pon cada petición en la capa más barata que la resuelva bien.
Capa 6: el ciclo de reentrenamiento
Una base de código es un blanco móvil. El modelo que entrenas en el primer trimestre está sutilmente equivocado en el tercero, porque tus convenciones, dependencias y arquitectura han avanzado. La última pieza del stack es un ciclo, no un hito: con una cadencia mensual o trimestral, lleva al pipeline los PR fusionados más recientes, reentrena el adaptador, ejecuta el arnés de evaluación y promueve el nuevo adaptador solo si supera al vigente en tus métricas. Cada ciclo amplía la distancia entre tu modelo y cualquier cosa que un competidor pueda conseguir pidiéndoselo a un modelo genérico, porque esa distancia es tu conocimiento de ingeniería acumulado.
El stack de un vistazo
- Datos: reunir repos, PR y documentación → limpiar, deduplicar, eliminar secretos → dar forma de pares FIM o de instrucciones → reservar los commits recientes.
- Modelo base: un modelo de código de pesos abiertos dimensionado para la tarea, con una licencia clara y contexto largo.
- Entrenamiento: LoRA/QLoRA con PEFT, Axolotl o Unsloth en una GPU reservada, con ejecuciones versionadas y protección contra el olvido.
- Evaluación: pruebas de ejecución, comprobaciones de lint y de tipos, y comparaciones cara a cara con referencias sobre un conjunto reservado.
- Servicio: vLLM/TGI + RAG, entregado en el IDE, la CI o un agente, con enrutamiento a una API frontera para la cola difícil.
- Reentrenamiento: un ciclo programado que mantiene el adaptador al día a medida que evoluciona el código.
Conclusión
Hacer fine-tuning de un modelo con la base de código de tu empresa ya no es un esfuerzo de investigación reservado a los laboratorios de IA: es un proyecto de ingeniería con un stack muy rodado. Un pipeline de datos disciplinado, una base de pesos abiertos, unas horas de entrenamiento LoRA en una GPU alquilada, un arnés de evaluación real, una capa de servicio rápida y un ciclo de reentrenamiento. Acierta con los datos y lo demás es fontanería. Lo que obtienes es una inteligencia que ningún competidor puede comprar ni conseguir a base de prompts: un modelo que escribe código como lo escribe tu organización.
Si estás valorando por dónde empezar (si hacer fine-tuning o apoyarte en la recuperación, qué tarea adaptar primero o cómo montar el pipeline de forma segura en tu propia infraestructura), reserva una llamada de descubrimiento gratuita y trazaremos el stack contigo.
IdeaToMVP Academy
Want to build with AI — not just read about it?
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.