
Entrenar GLM y otros modelos abiertos con tu propio código: lo que realmente te aporta (2026)

By Surya Pratap
29 de julio de 2026
11 min read
AI & Technology

29 de julio de 2026
11 min read
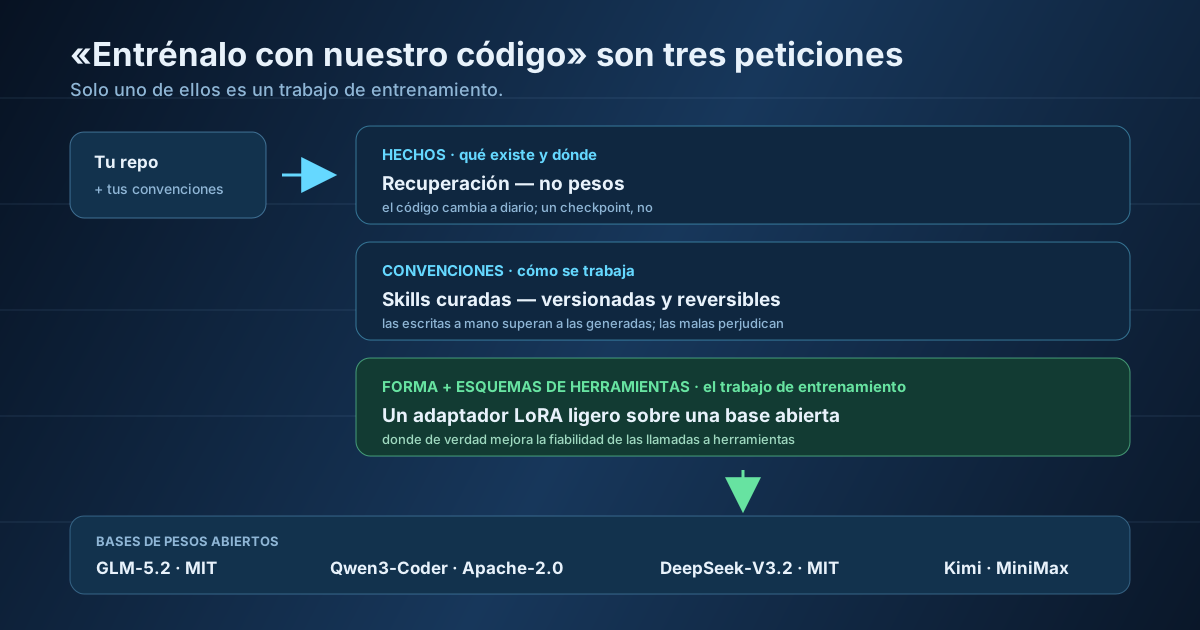
Cada pocas semanas un fundador hace alguna versión de la misma pregunta: ¿podemos coger un modelo abierto como GLM, entrenarlo con nuestro código y obtener un agente que programe como programa nuestro equipo? Es un buen instinto, y en 2026 por fin es razonable: el panorama de pesos abiertos es lo bastante sólido como para construir sobre él, y un fine-tuning que antes costaba decenas de miles hoy cuesta menos que una comida. Pero la petición esconde una trampa. «Entrénalo con nuestro código» son en realidad tres peticiones distintas bajo el mismo abrigo, y solo una de ellas es un trabajo de entrenamiento. Los equipos que hacen fine-tuning antes de separarlas se pasan un mes produciendo un modelo que escribe con el estilo de la casa y sigue sin saber qué servicio es responsable del reintento de facturación.
Esta es una guía práctica para hacerlo en el orden correcto: cómo está ahora mismo el panorama de pesos abiertos, cómo separar las tres peticiones, qué arregla de forma medible un adaptador LoRA, cuánto cuesta todo y cómo elegir un modelo base con tu propio repositorio en lugar de con la clasificación de otro.
Empecemos por por qué merece la pena. GLM-5.2, publicado por Z.ai en junio de 2026, es un modelo mixture-of-experts de 744.000 millones de parámetros con una ventana de contexto de un millón de tokens, pesos completos en Hugging Face y licencia MIT. Se construyó expresamente para programación, razonamiento y trabajo agéntico basado en herramientas, y queda a un punto porcentual aproximadamente de Opus 4.8 de Anthropic en un benchmark agéntico clave, a más o menos una quinta parte del coste. Lo de MIT importa más que el benchmark: puedes entrenarlo, distribuirlo y alojarlo sin pedir permiso a nadie.
No es la única opción, y la base adecuada depende de la forma de tu carga de trabajo. Qwen3-Coder-480B es Apache-2.0 y ronda el 69,6% en SWE-bench Verified, con variantes más pequeñas mucho más fáciles de autoalojar. DeepSeek-V3.2 tiene licencia MIT y llega a cerca del 70%. Kimi K2.6 es la elección para trabajo multimodal y multiagente, y MiniMax M3 para trabajos de bajo coste y alto rendimiento. En la práctica, GLM-5.2 es la opción por defecto más sólida para trabajo de agentes con contexto largo y horizonte largo, mientras que Qwen3-Coder es donde acaban la mayoría de los equipos cuando necesitan algo que funcione en hardware que controlan.
Una advertencia sobre las cifras: GLM-5.2 salió sin benchmarks independientes publicados, presentado por su fabricante como mejor que las versiones anteriores en programación de horizonte largo. Trata cada cifra de esta sección como un filtro, no como una decisión. Lo que nos lleva a la parte que de verdad importa.
Los benchmarks filtran, tu repositorio decide
Toma la decisión final con un conjunto de evaluación privado construido a partir de tus propias tareas, ejecutado sobre el checkpoint cuantizado exacto que vas a desplegar, dentro del mismo framework de agentes que usarás en producción. Un modelo que encabeza una clasificación a precisión completa puede comportarse de forma muy distinta a 4 bits dentro de tu harness.
Cuando alguien dice que quiere un modelo entrenado con su código, normalmente quiere tres cosas distintas a la vez. Nombrarlas por separado es la mayor parte del trabajo.
La primera petición son los hechos. Qué existe en el código base, dónde está, qué servicio es dueño de qué tabla, qué devuelve realmente esa función auxiliar. Esto es conocimiento, y el conocimiento cambia: tu repositorio cambia cada día y unos pesos no. Meter hechos en un checkpoint significa reentrenar cada vez que alguien hace merge. Esta petición pertenece a la recuperación, y se queda en la recuperación para siempre. El consenso de 2026 es tajante: si la respuesta depende de datos que cambian, usa recuperación, y haz fine-tuning solo para comportamientos que no deberían cambiar.
La segunda petición son las convenciones. Cómo hace las cosas tu equipo: la lista de revisión, el procedimiento de migraciones, la forma de envolver los errores, la regla de que nada habla con la base de datos fuera de una clase repositorio. Parece un problema de entrenamiento y casi nunca lo es. Los archivos de skills curados, instrucciones sencillas que describen cuándo y cómo hacer algo, te dan el mismo comportamiento al instante, funcionan con cualquier proveedor de modelos y se pueden editar, versionar, probar y revertir sin tocar un checkpoint. El fine-tuning cambia el comportamiento de forma permanente y es lento y engorroso de revertir; un archivo de skill es un pull request.
Aquí hay un matiz importante, y es uno de los hallazgos de investigación más útiles del año: la mera presencia de skills no garantiza nada. Las skills generadas automáticamente no aportan ningún beneficio de media, las curadas y escritas por personas superan de forma consistente a la línea base sin skills, y las de baja calidad empeoran de forma medible el rendimiento del agente. Así que no apuntes un modelo a tu repositorio para pedirle que escriba sus propias convenciones. Pide a tu mejor ingeniero que escriba diez reales, a mano, a partir de cosas que de verdad salen mal en las revisiones.
La tercera petición son la forma y los esquemas de herramientas, y esta sí es un trabajo de entrenamiento de verdad. Conseguir que el modelo emita tus llamadas a la API interna con tus nombres de parámetros, siga exactamente tu estructura de salida y elija de forma fiable la herramienta correcta de tu propio conjunto es justo aquello en lo que el fine-tuning es bueno. Esto es forma, no hechos, y es estable de un modo en que la ubicación de los archivos no lo es.
El ejemplo publicado más claro de la tercera petición es el de un equipo que necesitaba que un modelo entendiera sus esquemas de herramientas y su nomenclatura de parámetros concretos. La tasa de éxito de llamadas a herramientas de su agente era del 40%, que, si has lanzado un agente, reconocerás como la cifra en la que nada funciona y todo el mundo culpa al modelo. Tras un fine-tuning QLoRA estaban en el 90%. La ejecución costó unos 1.500 $ en total en una sola RTX 4090, y quedó a menos de un 1% de un fine-tuning completo en todos los benchmarks que midieron.
Fíjate en lo que se movió. No el conocimiento del modelo sobre su sistema, ni su capacidad general de programar, sino su cumplimiento de su interfaz. Esa es la promesa honesta de entrenar con tu propio código: agentes que dejan de equivocarse con tus herramientas. Si tu agente falla ahora porque se inventa nombres de parámetros, devuelve estructuras mal formadas o elige la herramienta equivocada, un adaptador lo arreglará. Si falla porque no conoce tu arquitectura, un adaptador no lo hará, y ninguna cantidad de entrenamiento lo hará.
El cómputo en bruto ya es casi gratis. Un fine-tuning LoRA o QLoRA de un modelo de 7–8B cuesta entre 3 y 10 $ en tiempo de GPU: de dos a cuatro horas en una A100 alquilada, menos de 3 $ en una 4090 que ya tengas. Una ejecución QLoRA de 70B ronda los 15–30 $. Los servicios gestionados cobran aproximadamente 0,48–0,50 $ por millón de tokens, así que un trabajo típico de 50M de tokens sobre un modelo de 8B sale por unos 25 $ alojado frente a 3–10 $ si lo haces tú. LoRA es la opción correcta en la inmensa mayoría de los casos, y los adaptadores se combinan sorprendentemente bien: un adaptador de estilo de código y uno de razonamiento de seguridad apenas interfieren entre sí.
La factura de GPU no es el coste
Entrenar cuesta 10 $. El presupuesto real se va en seleccionar ejemplos que representen cómo trabaja de verdad tu equipo y en construir el conjunto de evaluación que te dice si el adaptador ha ayudado. Los equipos que se saltan ambas cosas obtienen un modelo seguro de sí mismo y distinto, no mediblemente mejor, y ninguna forma de saber cuál de las dos cosas es.
La secuencia en la que convergieron los profesionales en 2026 es prompt, luego recuperación, luego fine-tuning, luego destilación, y el fine-tuning de mayor retorno es un adaptador LoRA ligero sobre un modelo base sólido, combinado con recuperación en lugar de sustituirla. Cada paso es más barato y más reversible que el siguiente, así que trabajar en orden significa que a menudo descubres que puedes parar antes.
Ese orden también te protege del error más caro aquí, que es atarte a un checkpoint demasiado pronto. La recuperación te permite cambiar de modelo base libremente; un fine-tuning no. Con la velocidad a la que se mueve este campo, de GLM-5.1 a 5.2 en pocos meses, quieres que la parte de tu sistema que codifica tu negocio sea la que puedas llevarte a un modelo base mejor en una tarde.
Hay una razón por la que esta conversación gira en torno a GLM y Qwen y no a las API cerradas. Entrenar con tu propio código significa que tu código se convierte en datos de entrenamiento, y con pesos MIT o Apache-2.0 puedes ejecutar ese proceso por completo dentro de infraestructura que controlas, lo que marca la diferencia entre una conversación con tu equipo de seguridad y una conversación con los equipos de seguridad de tus clientes. Para cualquiera que opere con compromisos de residencia de datos o condiciones de tratamiento empresariales, autoalojar una base abierta es a menudo la única versión de este proyecto que supera la revisión.
La segunda razón es la portabilidad. Pesos abiertos más un harness de agentes agnóstico al modelo significan que el adaptador que entrenaste este trimestre puede pasar a lo que lidere el campo el trimestre que viene. Es una posición muy distinta a construir tu flujo de trabajo sobre el producto de fine-tuning alojado de un único proveedor y esperar que los precios se mantengan.
Si quieres saber si algo de esto merece tu tiempo, no empieces con una ejecución de entrenamiento. Empieza por averiguar cuál de las tres peticiones te está costando de verdad.
Hazlo en ese orden y pasará una de dos cosas. O descubres que la mayor parte de tu dolor eran hechos y convenciones, y lo has resuelto en una semana con recuperación y archivos de skills, gratis, saltándote por completo el proyecto de entrenamiento. O encuentras un núcleo duro de fallos de interfaz que ningún prompt arregla, y gastas 10 $ en convertir una tasa del 40% de llamadas a herramientas en algo que puedes lanzar. Los dos son buenos resultados. El malo es aquel en el que empiezas por el fine-tuning, porque es la parte más interesante, y acabas con un modelo que ha aprendido tu estilo de la casa lo bastante bien como para equivocarse en él de forma convincente.
El panorama de pesos abiertos cruzó este año un umbral real: por primera vez, un fundador puede tomar un modelo de programación de clase frontera con licencia MIT, adaptarlo a sus propias interfaces por el precio de un café y ejecutarlo todo en hardware que controla. Es un cambio genuino en lo que un equipo pequeño puede poseer. Solo conviene recordar que la palanca viene de saber cuál de las tres peticiones estás respondiendo, no de la ejecución de entrenamiento en sí.



IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.