Mythos dijo que en curl ya no quedaba nada. Una startup encontró seis CVE

By Surya Pratap
24 de septiembre de 2026
10 min read
AI & Technology

24 de septiembre de 2026
10 min read
 Cero, y después veintinueveHover to explore
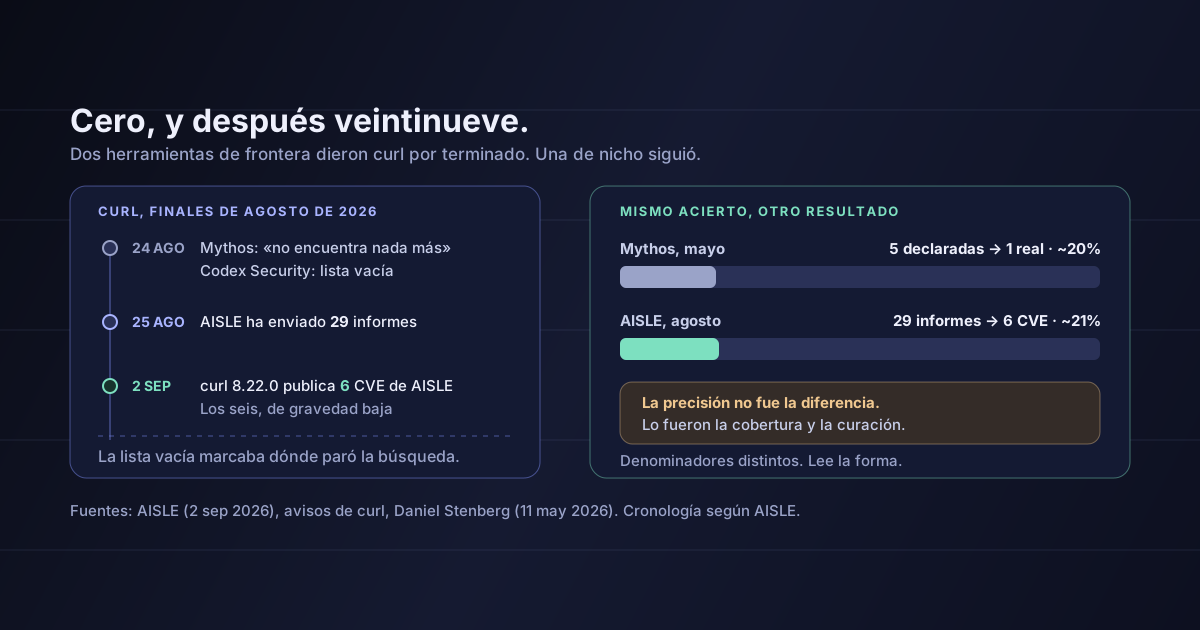
El 24 de agosto, Daniel Stenberg, mantenedor de curl, publicó dos líneas de estado. Mythos, de Anthropic, «dice que no encuentra nada más». Codex Security, de OpenAI, «muestra una lista vacía». Al día siguiente publicó un marcador: Mythos: 0 / Aisle: 29.
Seis de esos veintinueve informes se convirtieron en CVE y quedaron corregidos en curl 8.22.0, publicado el 2 de septiembre. Casi toda la cobertura ha contado alguna versión de una startup gana a OpenAI y a Anthropic. Es cierto, hasta donde llega. También es lo menos útil que se puede sacar de este episodio.
Las cifras de este artículo proceden del relato de AISLE sobre los hallazgos de agosto (2 de septiembre de 2026), de la tabla de vulnerabilidades del propio curl, del análisis de Daniel Stenberg sobre el escaneo de Mythos (11 de mayo de 2026) y de la información de ZDNET (4 de septiembre de 2026). AISLE es un proveedor que describe su propio resultado; los avisos de curl son la comprobación independiente. La lectura a partir de la sección 3 es mía.
La cronología es lo bastante corta para contarla entera.
Anthropic y Alpha-Omega pasaron Mythos por el código. Declaró cinco «vulnerabilidades de seguridad confirmadas». El equipo de seguridad de curl las revisó y se quedó con una, de gravedad baja. Tres eran falsos positivos que describían comportamiento documentado de la API, una era «solo un bug» y del escaneo salieron unos veinte fallos más que no eran de seguridad. El veredicto de Stenberg: el ruido alrededor del modelo era «sobre todo marketing», y Mythos quizá era «un poco mejor» que herramientas anteriores, no espectacularmente mejor.
Mythos no encuentra nada más. Codex Security: lista vacía. ZDNET añade que ZeroPath, otro escáner con IA, tampoco había encontrado nada nuevo.
El 28 de agosto, el recuento de CVE pendientes de curl había pasado de tres a diez, seis de ellos de AISLE.
La tabla de curl recoge los seis: un use-after-free en el proveedor de OpenSSL, una elusión del pinning en OpenSSL, reutilización de conexiones con el almacén nativo de CA, una elusión del atributo secure de las cookies con un tabulador, un acierto en la caché de CA de wolfSSL que anula un callback y una cookie de dominio sobre un sufijo público. Los seis tienen gravedad baja. Algunos vienen de lejos: la elusión del pinning afecta a todas las versiones desde la 7.45.0.
AISLE afirma además que se le atribuyeron seis CVE en la versión de junio, la 8.21.0, entre ellos uno que describe como la vulnerabilidad más antigua jamás reportada en curl, introducida en marzo de 2001. No he podido confirmar esa atribución en las páginas del propio curl, así que la dejo fuera del argumento.
Greg Kroah-Hartman, mantenedor de la rama estable del kernel de Linux, añadió la frase que convirtió esto en algo más que una historia de curl: «Estoy viendo lo mismo en Linux. No tengo ni idea de qué hace Aisle distinto, pero vaya…».
Estas son las dos pasadas sobre curl con suficientes cifras publicadas para compararlas:
No es la misma medida. Las cinco de Mythos ya venían etiquetadas como vulnerabilidades confirmadas, mientras que las 29 de AISLE eran informes, y parte de los otros 23 pueden haber sido fallos legítimos y no ruido. Pero la idea general aguanta la salvedad: AISLE no ganó por precisión. Los dos sistemas pusieron delante del mantenedor unos cuatro informes sin confirmar por cada uno que acabó siendo un hallazgo real.
La diferencia no fue que AISLE acertara más a menudo. Fue que AISLE seguía buscando cuando las demás herramientas ya habían parado.
Eso cambia de qué va la historia. Un modelo de frontera que se ejecuta, informa de lo que encontró y luego dice que no queda nada te está diciendo dónde terminó su búsqueda. El resultado de AISLE dice que los fallos de curl no terminaban ahí. La capacidad que importó fue la cobertura, no el criterio sobre cada hallazgo concreto.
Esta es la parte que te afecta aunque nunca toques curl.
Cuando un escáner dice que no ha encontrado nada, sabes qué pudo ver esa herramienta desde donde miró. No sabes que el código esté limpio. Eso siempre ha sido así con los analizadores estáticos y los fuzzers, y precisamente por eso los ingenieros de seguridad ejecutan varios. El riesgo nuevo es que los escáneres con IA explican sus resultados con soltura, y «he revisado el código y no he encontrado más vulnerabilidades» suena a conclusión, no a límite de cobertura.
Dos maneras de leer el mismo cero
Leído como veredicto: el código no tiene más hallazgos de este tipo. A producción.
Leído como límite: esta herramienta, con este prompt, este presupuesto de contexto y esta estrategia de búsqueda, dejó de producir hallazgos. Otra con una estrategia distinta quizá no.
curl en agosto es un caso limpio en el que la segunda lectura era la correcta, y en uno de los códigos C más fuzzeados y auditados que existen.
Si un proyecto maduro con un proceso de seguridad a tiempo completo puede tener seis CVE reales escondidos tras dos listas vacías, un SaaS de doce meses que pasó un escaneo con IA antes de su auditoría SOC 2 no ha demostrado gran cosa.
Ninguna de las dos publicaciones de AISLE describe su arquitectura, así que cualquier detalle sobre cómo funciona sería especulación y no voy a ofrecerlo. Hay dos cosas registradas, y bastan.
La primera es el propio planteamiento de AISLE: «La capacidad en ciberseguridad es irregular: en tareas de seguridad bien definidas, modelos más pequeños pueden superar a LLM mucho más grandes y caros». Encaja con lo que vemos al construir agentes de nicho. Un modelo generalista está ajustado para hacerlo razonablemente bien en todo. Un sistema construido para una sola tarea puede gastar todo su presupuesto en el espacio de búsqueda de esa tarea —qué subsistemas, qué configuraciones, qué interacciones entre backends TLS y reutilización de conexiones—, y los seis hallazgos de agosto viven justo en ese tipo de rincón.
La segunda es lo que notó el mantenedor. Los elogios de Stenberg no iban sobre capacidad bruta. Dijo que AISLE «dedica tiempo de ingeniería de verdad a asegurarse de que recibimos resultados cuidados y de máxima calidad». Jim Fuller, de Red Hat, dijo algo parecido: «ha trabajado más que limitarse a pasar un escáner».
Si se juntan las dos cosas, el producto queda claro:
No es un modelo mejor. Es una estrategia de búsqueda apuntada a un solo dominio, más una curación de nivel humano antes de que nada llegue a quien tiene que actuar. Mythos y Codex Security son herramientas generalistas al alcance de cualquiera. AISLE es un sistema que alguien diseñó para este trabajo y que estuvo dispuesto a seguir ejecutando cuando el terreno evidente ya estaba cubierto.
Este episodio es probablemente la prueba pública más clara hasta ahora para una discusión que los fundadores tienen una y otra vez con los inversores: ¿qué impide que el laboratorio haga esto?
La herramienta del laboratorio se detiene donde es generalista. Mythos y Codex Security están hechos para funcionar sobre cualquier repositorio. Esa amplitud es justo la razón por la que fueron los primeros en rendirse con curl. Tu cuña es la profundidad que ellos no pueden justificar construir para un solo vertical.
Vende resultados aceptados, no salida en bruto. A curl no le importaban 29 informes. Le importaban seis CVE y el tiempo del mantenedor que costó llegar a ellos. Si tu producto genera hallazgos, borradores o leads, la cifra que nota tu comprador es la que sobrevive a su revisión, por hora de su tiempo.
La curación es producto, no gasto general. La misma tasa de acierto del 20% es un regalo cuando alguien la ha revisado antes y un coste cuando no. Stenberg llama al momento actual de los informes de seguridad con IA una «era de caos de alta calidad». Un producto que absorbe ese caos vale más que uno que lo reenvía.
Elige una verdad de referencia que califique otro. La afirmación de AISLE es creíble porque fueron los mantenedores de curl, no AISLE, quienes decidieron qué contaba. Busca el equivalente en tu dominio —un auditor, un regulador, una pull request fusionada— y rinde cuentas frente a eso, no frente a tu propio panel.
La mitad incómoda de la misma lección: si tu producto es una capa fina que ejecuta un modelo de frontera una vez y formatea la respuesta, así es como se ve tu competidor.
Cuatro cambios, todos baratos:
Dos herramientas generalistas de frontera suelen compartir puntos ciegos. Combina una con un analizador estático tradicional, un fuzzer sobre tus parsers o una herramienta especializada. La diversidad de método es lo que encuentra la segunda capa.
Anota qué herramienta, qué versión, qué rutas y qué fecha. Un resultado vacío sin alcance es lo que acaba citado en un cuestionario de seguridad como prueba de algo que nunca midió.
Con un hallazgo real de cada cinco, un escaneo que devuelve cuarenta elementos es una semana de ingeniería. Decide quién revisa y con qué rapidez antes de encender la herramienta, o los informes se quedarán ahí pudriéndose.
Cuatro de los seis hallazgos de agosto en curl están en el comportamiento de los backends TLS y los otros dos en casos límite del análisis de cookies: interacciones de configuración, no el camino obvio de la petición. En tu producto, el equivalente suele ser los casos límite de autenticación, las fronteras entre clientes en un sistema multi-tenant y cualquier cosa que guarde credenciales en caché.
AISLE es la fuente de casi toda la historia. La cronología, los 29 y el enfoque salen de la propia publicación de AISLE. La tabla de curl confirma de forma independiente los seis CVE y su gravedad; nada independiente confirma cuánto cómputo, tiempo o esfuerzo humano costó producirlos.
La comparación no está controlada. Mythos se ejecutó en mayo y AISLE a finales de agosto, sobre un código que cambió entretanto y que ya había absorbido los hallazgos de Mythos. Eso hace el resultado de AISLE, si acaso, más difícil, no más fácil, pero sigue sin ser un benchmark.
Los seis son de gravedad baja. Es lo normal en curl, donde rara vez queda otra cosa por encontrar, pero significa que este episodio demuestra cobertura, no la capacidad de encontrar fallos críticos que otros pasaron por alto.
La comparación entre el 20% y el 21% es aproximada. Los dos denominadores se etiquetaron de forma distinta, como dice la sección 2. La uso para mostrar que la precisión no fue la diferencia evidente, no para afirmar que ambas sean igual de precisas.
El comentario de Kroah-Hartman sobre Linux es una sola frase. «Estoy viendo lo mismo» es una señal que conviene vigilar, no un resultado publicado.
La versión fácil de esta historia es David contra Goliat. La versión útil trata de qué significa un resultado vacío.
Dos de los sistemas de IA mejor financiados del mundo miraron un código muy auditado y dijeron que no quedaba nada. Los dos describían con exactitud su propia búsqueda. Un sistema más acotado, con otra estrategia y con personas que revisaron su salida antes de enviarla, encontró seis vulnerabilidades reales en cuestión de días. Su tasa de acierto no era mejor. Simplemente siguió adelante y limpió lo que producía.
Para un fundador que construye sobre modelos de frontera, esa es la ventaja competitiva dicha sin rodeos: profundidad en un dominio y curación antes de que nada llegue a una persona. Para un fundador que publica código, es una advertencia igual de directa.
Trata cada «sin hallazgos» como el borde de la búsqueda de una herramienta, y deja por escrito dónde estaba ese borde.
Fuentes: AISLE, «AISLE Discovered Six curl CVEs After OpenAI and Anthropic Found Zero», Stanislav Fort, 2 de septiembre de 2026: las citas de Stenberg del 24 y el 25 de agosto, los 29 informes, el paso de tres a diez CVE pendientes y la cita de Kroah-Hartman, tal como se publicaron. Tabla de vulnerabilidades de curl para la 8.21.0: los seis identificadores (CVE-2026-80229, -80230, -80231, -80255, -82208, -82209), sus títulos, los rangos de versiones afectadas y la gravedad baja. Daniel Stenberg, «Mythos finds a curl vulnerability», 11 de mayo de 2026: las cinco declaradas, la confirmada, los tres falsos positivos, los unos veinte fallos y la valoración de «sobre todo marketing». Steven Vaughan-Nichols, ZDNET, vía Yahoo Tech, 4 de septiembre de 2026: el dato sobre ZeroPath, las citas de Stenberg sobre la «era de caos de alta calidad» y los «resultados cuidados», y el comentario de Jim Fuller. Las afirmaciones de AISLE de junio proceden de su publicación sobre la 8.21.0, incluida la cita sobre la capacidad «irregular». La comparación de proporciones de la sección 2 y todo lo que va desde la sección 3 es mío. Para otro caso en el que el propio informe del agente era lo que no había que creer, ver tu agente de código fijó el commit. Para el argumento de que los modelos pequeños ganan en decisiones acotadas, ver la mayor parte de lo que tu agente le pide a un LLM es un sí o un no.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.