
74 de 100 artigos científicos tornaram-se agentes funcionais. As ferramentas vieram dos tutoriais, não do código

By Surya Pratap
27 de setembro de 2026
9 min read
AI & Technology

27 de setembro de 2026
9 min read
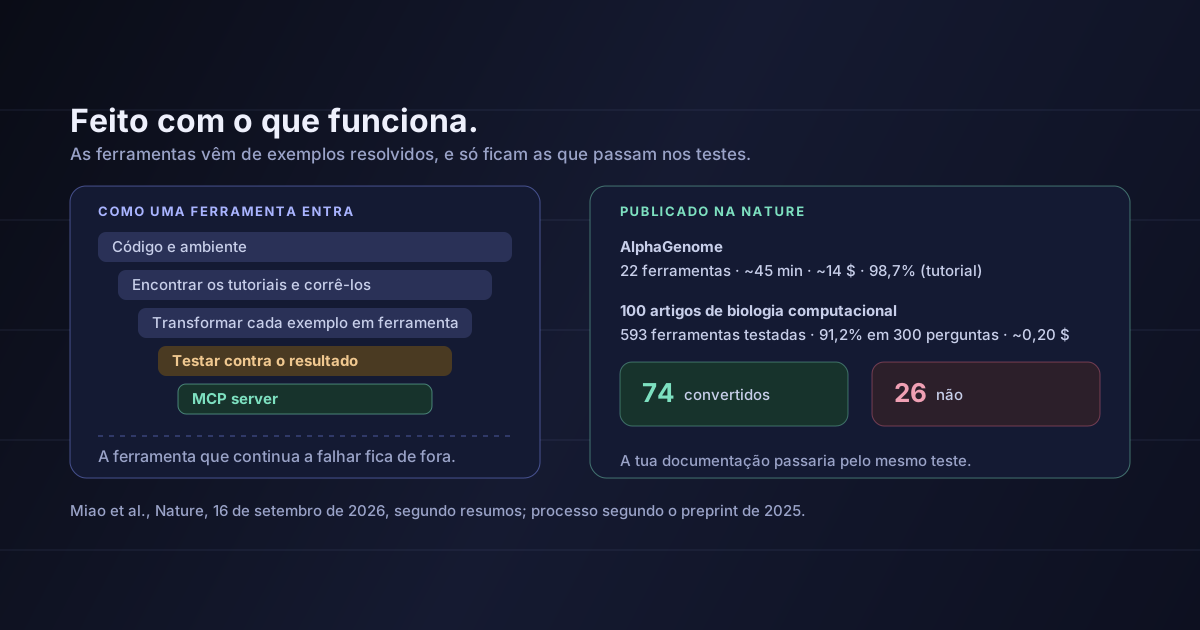 Feito com o que funcionaHover to explore
A maioria das tentativas de tornar um repositório utilizável por um agente começa pelo código: aponta-se o modelo ao repositório e deixa-se que descubra o que chamar. Um artigo publicado este mês na Nature faz algo mais estreito, e os resultados sugerem que é essa abordagem mais estreita que vale a pena copiar.
O Paper2Agent foi publicado na Nature a 16 de setembro de 2026 por Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard e James Zou. O artigo da Nature é pago, por isso os números publicados que uso vêm de dois resumos da AI Weekly que concordam nesses números. Os pormenores do processo e a comparação com outros sistemas vêm do preprint de 2025 dos mesmos autores, uma versão anterior do trabalho, e indico sempre qual é qual. O código é de código aberto. A leitura a partir da secção 3 é minha.
O Paper2Agent pega num artigo científico e no respetivo código e produz um servidor Model Context Protocol (MCP): um conjunto de ferramentas que qualquer assistente compatível com MCP pode chamar, cada uma a aplicar um método do artigo a dados novos.
O preprint descreve seis passos: encontrar o código, preparar o ambiente, encontrar os tutoriais, corrê-los, transformar cada exemplo resolvido numa ferramenta e montar as ferramentas num servidor. Quatro subagentes dividem o trabalho: um gere o ambiente, outro procura os tutoriais, outro transforma os tutoriais em funções e outro escreve e corre os testes.
O que importa são os testes. Cada ferramenta extraída é testada contra o resultado do próprio tutorial, num ciclo de escrever testes, corrê-los, diagnosticar falhas e corrigir. A fasquia do preprint é que a ferramenta reproduza os resultados originais. Uma ferramenta que continua a falhar fica fora do servidor.
Não embrulha tudo o que está no repositório. Embrulha o que comprovadamente funciona, e deixa o resto de fora.
Segundo os resumos da versão da Nature:
O preprint, publicado um ano antes, comparou um agente do AlphaGenome com duas alternativas em 15 perguntas de tutorial e 15 novas. O agente do artigo respondeu bem às 30. O Claude com acesso direto ao repositório acertou 9 em 15 perguntas de tutorial e 12 em 15 novas. O Biomni, um agente biomédico generalista, acertou 6 em 15 e 9 em 15. O agente do artigo foi também mais rápido, entre 1,8 e 4,6 vezes, conforme a comparação.
A comparação, com o tamanho da amostra
Quinze perguntas por condição é pouco, e vem do preprint, não da versão publicada. Os números publicados para o mesmo caso são ligeiramente diferentes. Uso a comparação pela direção — uma camada de ferramentas testadas superou o acesso direto ao repositório — e não pela dimensão exata.
Um agente apontado a um repositório em bruto tem de descobrir, em cada pergunta, que função importa, que argumentos são válidos, por que ordem as coisas correm e qual das três funções auxiliares quase iguais é a que os autores usaram de facto. Pode ser bom nisto e mesmo assim errar muitas vezes, porque o repositório não diz quais são os caminhos certos.
Um tutorial diz. É a declaração do próprio autor de é assim que o método deve ser usado, com as entradas, a sequência de chamadas e o resultado esperado. Transformar tutoriais em ferramentas dá ao agente um pequeno conjunto de operações que já têm uma resposta certa conhecida. Testar cada ferramenta contra essa resposta transforma um palpite em algo verificado.
É o mesmo padrão que faz com que, em produção, ferramentas pequenas e bem definidas superem ferramentas grandes e genéricas: menos escolhas, cada uma verificada. O que o Paper2Agent acrescenta é uma forma de produzir essa camada automaticamente, a partir de material que a maioria dos projetos já tem.
Os resumos não explicam as falhas, e não vou especular artigo a artigo. A secção de limitações do preprint é geral, mas clara: artigos com código incompleto, mal documentado ou propenso a erros não podem ser convertidos de forma fiável.
Posto ao lado do funcionamento do processo, isto descreve um teste que o teu próprio produto enfrentaria. Se os teus exemplos não correm a partir de um ambiente limpo, não há nada para extrair. Se correm mas ninguém escreveu o resultado esperado, não há nada contra o qual testar. Se a única documentação é uma referência da API, o agente volta a ter de adivinhar que chamadas importam.
Por isso, a pergunta prática para um fundador não é «devemos criar um servidor MCP?», mas:
Se alguém corresse este processo amanhã no teu repositório público, quantas ferramentas testadas e funcionais sairiam?
Torna cada tutorial executável de raiz. Um comando para preparar o ambiente, sem estado escondido, sem «e depois configura as credenciais de alguma forma». Um tutorial que só funciona no portátil do autor não serve de exemplo a ninguém, pessoa ou agente.
Escreve o resultado esperado. Um exemplo resolvido sem resultado é uma sugestão. Com resultado, é um teste. Essa única mudança é o que permite a qualquer processo automático — ou à tua própria CI — distinguir uma ferramenta que funciona de uma que só parece funcionar.
Constrói o servidor MCP a partir dos exemplos, não da referência. Expor todos os endpoints dá ao agente uma superfície enorme sobre a qual adivinhar. Expor as dez tarefas que os teus tutoriais mostram, cada uma testada, dá-lhe uma superfície pequena que funciona. A amplitude pode vir depois.
Testa as ferramentas, não só o servidor. Um servidor que arranca não é um servidor que funciona. Mantém um teste por ferramenta que confirme que ainda reproduz o resultado do seu tutorial, e corre-o em cada versão, porque a tua API vai mudar e as ferramentas vão desviar-se sem aviso.
O argumento do custo também merece atenção. Segundo os números publicados, converter um dos casos levou cerca de 45 minutos e 14 dólares, e cada consulta custa cerca de 0,20 dólares. Seja qual for o teu produto, uma primeira versão de uma interface para agentes construída assim não é um projeto de um trimestre.
A mesma lição vale do outro lado. Se o teu agente precisa de usar uma biblioteca, um serviço interno ou o SDK de um fornecedor, não lhe entregues o repositório e esperes pelo melhor. Encontra os exemplos resolvidos, transforma cada um numa ferramenta estreita, testa cada ferramenta contra o resultado do exemplo e dá ao agente só essas. A comparação do preprint é pequena, mas aponta no mesmo sentido que a maior parte da experiência em produção: um agente que escolhe entre poucas ferramentas que funcionam sai-se melhor do que um que escolhe entre tudo o que existe.
Não li o artigo completo da Nature. É pago. Os números publicados vêm de dois resumos do mesmo meio, a AI Weekly, que concordam em todos os números que uso. A cobertura não é totalmente coerente num outro número do AlphaGenome, 82,7%, que um resumo apresenta como o resultado em perguntas abertas de investigadores e outro descreve como uma comparação com outro sistema, por isso deixei-o de fora. A descrição do processo e a comparação vêm do preprint de 2025, uma versão anterior com números ligeiramente diferentes.
Isto é biologia computacional. Os tutoriais e o código seguem convenções partilhadas. Não foi testado se a mesma taxa de sucesso se mantém em software genérico, onde os exemplos costumam ser menos cuidados.
Perguntas derivadas de tutoriais favorecem ferramentas derivadas de tutoriais. Uma ferramenta construída a partir de um tutorial sai-se bem em perguntas tiradas desse mesmo tutorial. O conjunto de 300 perguntas e as perguntas novas do preprint são melhor prova, e mesmo essas foram escritas pelos investigadores.
Falta a análise das falhas. Vinte e seis dos 100 artigos não foram convertidos, e os resumos não dizem porquê. A minha leitura da secção 4 usa as limitações gerais do preprint, não uma análise desses 26 artigos.
A comparação é pequena. Quinze perguntas por condição, do preprint. Mostra uma direção, não uma diferença precisa.
O título do Paper2Agent é que os artigos científicos podem tornar-se agentes. Para os fundadores, o resultado mais útil é o como: não embrulhar um repositório, mas extrair os exemplos resolvidos que correm, testar cada um contra o resultado conhecido e descartar as ferramentas que falham.
Isso transforma a documentação em algo mais próximo de uma especificação de interface. Os projetos que foram convertidos foram aqueles cujos exemplos podiam ser corridos e verificados. Os restantes são um retrato razoável do que acontece a um produto cujos tutoriais ficaram desatualizados.
Corre esta semana os teus próprios tutoriais a partir de um ambiente limpo e escreve o que cada um deve devolver. É a maior parte do trabalho para tornar o teu produto utilizável por agentes.
Fontes: Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard e James Zou, «Reimagining research papers as interactive and reliable AI agents», Nature, 16 de setembro de 2026 — números publicados segundo os resumos da AI Weekly «Paper2Agent turns research papers into working AI agents» e «Paper2Agent converts research papers into callable AI agents»: as 22 ferramentas, os 45 minutos e os 14 dólares, os 98,7 ± 1,3% em perguntas de tutorial, os 74 de 100 artigos, as 593 ferramentas, os 91,2 ± 1,6% em 300 perguntas, e os 0,20 dólares e 1,6 minutos por consulta. O preprint dos mesmos autores, «Paper2Agent: Reimagining Research Papers As Interactive and Reliable AI Agents», arXiv:2509.06917, v2 de 16 de outubro de 2025 — o processo em seis passos, os quatro subagentes, o ciclo de testes e a exclusão das ferramentas que falham, a comparação em 15 mais 15 perguntas com o Claude com acesso ao repositório e com o Biomni, as proporções de tempo de execução e as limitações declaradas. Código: Paper2Agent no GitHub, licença MIT. A leitura das secções 3 a 6 é minha. Sobre o que o MCP está a mudar este ano, ver o MCP foi pensado para uma pessoa em frente a um portátil. Sobre porque é que um agente que lê tudo custa mais do que parece, ver cada ficheiro que o teu agente lê fica na fatura.

IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.