
74 van de 100 onderzoeksartikelen werden werkende agents. De tools kwamen uit de tutorials, niet uit de code

By Surya Pratap
27 september 2026
9 min read
AI & Technology

27 september 2026
9 min read
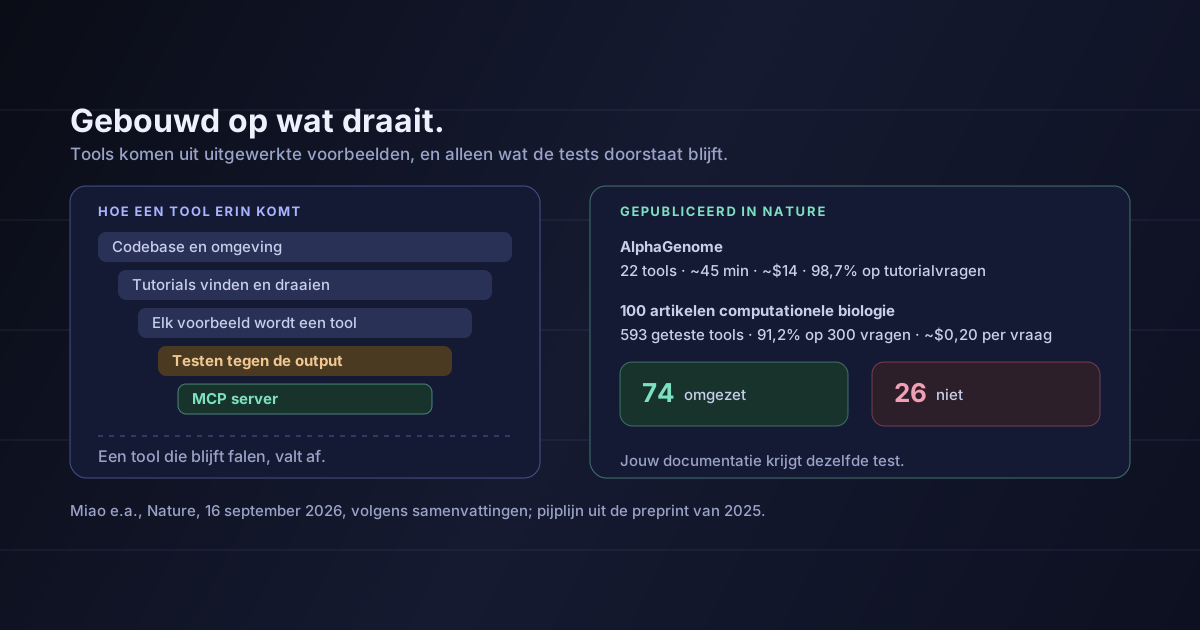 Gebouwd op wat draaitHover to explore
De meeste pogingen om een codebase bruikbaar te maken voor een agent beginnen bij de code: je richt het model op de repository en laat het uitzoeken wat het moet aanroepen. Een artikel dat deze maand in Nature verscheen, doet iets smallers, en de resultaten suggereren dat juist die smallere aanpak de moeite van het kopiëren waard is.
Paper2Agent verscheen op 16 september 2026 in Nature, van Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard en James Zou. Het Nature-artikel zit achter een betaalmuur, dus de gepubliceerde cijfers die ik gebruik komen uit twee samenvattingen van AI Weekly die het over die cijfers eens zijn. De details van de pijplijn en de vergelijking met andere systemen komen uit de preprint van 2025 van dezelfde auteurs, een eerdere versie van het werk, en ik zeg steeds welke bron het is. De code is open source. De interpretatie vanaf sectie 3 is van mij.
Paper2Agent neemt een onderzoeksartikel en de bijbehorende code en maakt daar een Model Context Protocol-server (MCP) van: een set tools die elke MCP-compatibele assistent kan aanroepen, elk bedoeld om een methode uit het artikel op nieuwe data toe te passen.
De preprint beschrijft zes stappen: de codebase vinden, de omgeving opzetten, de tutorials vinden, ze draaien, elk uitgewerkt voorbeeld omzetten in een tool, en de tools samenvoegen tot een server. Vier sub-agents verdelen het werk: één beheert de omgeving, één zoekt tutorials, één zet tutorials om in functies, en één schrijft en draait tests.
Het belangrijkste deel is het testen. Elke geëxtraheerde tool wordt getest tegen de output van de tutorial zelf, in een lus van tests schrijven, draaien, fouten analyseren en herstellen. De lat in de preprint is dat een tool de oorspronkelijke resultaten reproduceert. Een tool die blijft falen, komt niet op de server.
Het verpakt niet alles wat in de repository staat. Het verpakt wat aantoonbaar werkt, en laat de rest vallen.
Volgens de samenvattingen van de Nature-versie:
De preprint, een jaar eerder verschenen, vergeleek een AlphaGenome-agent met twee alternatieven op 15 tutorialvragen en 15 nieuwe vragen. De agent uit het artikel beantwoordde alle 30 goed. Claude met directe toegang tot de repository beantwoordde 9 van de 15 tutorialvragen en 12 van de 15 nieuwe. Biomni, een algemene biomedische agent, haalde 6 van de 15 en 9 van de 15. De agent uit het artikel was bovendien sneller, tussen 1,8 en 4,6 keer, afhankelijk van de vergelijking.
Lees de vergelijking met de steekproefgrootte erbij
Vijftien vragen per conditie is weinig, en het komt uit de preprint, niet uit de gepubliceerde versie. De gepubliceerde cijfers voor dezelfde casus wijken iets af. Ik gebruik de vergelijking voor de richting — een laag geteste tools versloeg directe toegang tot de repository — niet voor de precieze omvang.
Een agent die op een kale repository is gericht, moet bij elke vraag uitzoeken welke functie ertoe doet, welke argumenten geldig zijn, in welke volgorde dingen draaien, en welke van de drie bijna identieke helpers de auteurs echt gebruikten. Hij kan daar goed in zijn en er toch vaak naast zitten, want de repository zegt niet welke paden de echte zijn.
Een tutorial zegt dat wel. Het is de verklaring van de auteur zelf: zo is de methode bedoeld, met invoer, de volgorde van aanroepen en de verwachte output. Door tutorials om te zetten in tools krijgt de agent een kleine set bewerkingen die al een bekend goed antwoord hebben. Door elke tool tegen dat antwoord te testen, wordt een gok iets wat is gecontroleerd.
Het is hetzelfde patroon waardoor kleine, goed afgebakende tools in productie beter werken dan grote, algemene: minder keuzes, elk geverifieerd. Wat Paper2Agent toevoegt, is een manier om die laag automatisch te maken, uit materiaal dat de meeste projecten al hebben.
De samenvattingen verklaren de mislukkingen niet, en ik ga niet per artikel gissen. De sectie met beperkingen in de preprint is algemeen maar duidelijk: artikelen met onvolledige, slecht gedocumenteerde of foutgevoelige codebases kunnen niet betrouwbaar worden omgezet.
Leg dat naast hoe de pijplijn werkt, en het beschrijft een test die je eigen product ook zou krijgen. Draaien je voorbeelden niet vanuit een schone omgeving, dan valt er niets te extraheren. Draaien ze wel maar heeft niemand de verwachte output opgeschreven, dan valt er niets tegen te testen. Is de enige documentatie een API-referentie, dan moet de agent weer raden welke aanroepen ertoe doen.
De praktische vraag voor een founder is dus niet 'moeten we een MCP-server bouwen?', maar:
Als iemand deze pijplijn morgen op je openbare repository zou draaien, hoeveel werkende, geteste tools zouden eruit komen?
Maak elke tutorial uitvoerbaar vanaf nul. Eén commando om de omgeving op te zetten, geen verborgen state, geen 'en regel dan je credentials op de een of andere manier'. Een tutorial die alleen op de laptop van de auteur werkt, is voor niemand een voorbeeld, mens of agent.
Schrijf de verwachte output op. Een uitgewerkt voorbeeld zonder resultaat is een suggestie. Met resultaat is het een test. Die ene verandering laat elke geautomatiseerde pijplijn — of je eigen CI — het verschil zien tussen een tool die werkt en een die alleen zo lijkt.
Bouw je MCP-server uit voorbeelden, niet uit de referentie. Elk endpoint aanbieden geeft een agent een groot oppervlak om op te gokken. De tien taken aanbieden die je tutorials laten zien, elk getest, geeft een klein oppervlak dat werkt. De breedte komt later.
Test de tools, niet alleen de server. Een server die opstart, is nog geen server die werkt. Houd per tool een test bij die controleert of hij de output van zijn tutorial nog reproduceert, en draai die bij elke release, want je API verandert en de tools gaan ongemerkt afwijken.
Het kostenargument is ook de moeite waard. Volgens de gepubliceerde cijfers kostte het omzetten van één casus ongeveer 45 minuten en $14, en kost een vraag ongeveer $0,20. Wat je product ook is, een eerste versie van een interface voor agents die zo is gebouwd, is geen project van een kwartaal.
Dezelfde les geldt van de andere kant. Moet je agent een library, een interne service of de SDK van een leverancier gebruiken, geef hem dan niet de repository in de hoop dat het goed gaat. Zoek de uitgewerkte voorbeelden, maak van elk een smalle tool, test elke tool tegen de uitkomst van het voorbeeld, en geef de agent alleen die tools. De vergelijking in de preprint is klein, maar wijst dezelfde kant op als de meeste ervaring in productie: een agent die kiest uit een paar tools die werken, doet het beter dan een agent die kiest uit alles wat bestaat.
Ik heb het volledige Nature-artikel niet gelezen. Het zit achter een betaalmuur. De gepubliceerde cijfers komen uit twee samenvattingen van hetzelfde medium, AI Weekly, die het eens zijn over elk cijfer dat ik gebruik. Over één ander AlphaGenome-cijfer, 82,7%, is de berichtgeving niet helemaal consistent: de ene samenvatting noemt het de score op open vragen van onderzoekers, de andere een vergelijking met een ander systeem. Daarom heb ik het weggelaten. De beschrijving van de pijplijn en de vergelijking komen uit de preprint van 2025, een eerdere versie met iets andere cijfers.
Dit is computationele biologie. De tutorials en code in dat veld volgen gedeelde conventies. Of hetzelfde slagingspercentage geldt voor algemene software, waar voorbeelden vaak minder netjes zijn, is niet getest.
Vragen uit tutorials bevoordelen tools uit tutorials. Een tool die uit een tutorial is gebouwd, scoort goed op vragen uit diezelfde tutorial. De benchmark van 300 vragen en de nieuwe vragen uit de preprint zijn beter bewijs, en zelfs die zijn door de onderzoekers zelf geschreven.
De analyse van de mislukkingen ontbreekt. Zesentwintig van de 100 artikelen werden niet omgezet, en de samenvattingen zeggen niet waarom. Mijn lezing in sectie 4 leunt op de algemene beperkingen uit de preprint, niet op een uitsplitsing van die 26 artikelen.
De vergelijking is klein. Vijftien vragen per conditie, uit de preprint. Ze laat een richting zien, geen precies verschil.
De kop van Paper2Agent is dat onderzoeksartikelen agents kunnen worden. Voor founders is het nuttigere resultaat het hoe: niet een codebase verpakken, maar de uitgewerkte voorbeelden die draaien eruit halen, elk testen tegen de bekende uitkomst, en de tools die falen weggooien.
Daarmee wordt documentatie iets wat meer op een interfacespecificatie lijkt. De projecten die werden omgezet, waren de projecten waarvan de voorbeelden konden worden gedraaid en gecontroleerd. De rest geeft een redelijk beeld van wat er gebeurt met een product waarvan de tutorials niet meer kloppen.
Draai deze week je eigen tutorials vanuit een schone omgeving, en schrijf op wat elk ervan hoort op te leveren. Dat is het grootste deel van het werk om je product bruikbaar te maken voor agents.
Bronnen: Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard en James Zou, 'Reimagining research papers as interactive and reliable AI agents', Nature, 16 september 2026; gepubliceerde cijfers volgens de samenvattingen van AI Weekly, 'Paper2Agent turns research papers into working AI agents' en 'Paper2Agent converts research papers into callable AI agents': de 22 tools, 45 minuten en $14, de 98,7 ± 1,3% op tutorialvragen, de 74 van de 100 artikelen, de 593 tools, de 91,2 ± 1,6% op 300 vragen, en de $0,20 en 1,6 minuut per vraag. De preprint van dezelfde auteurs, 'Paper2Agent: Reimagining Research Papers As Interactive and Reliable AI Agents', arXiv:2509.06917, v2 van 16 oktober 2025: de pijplijn in zes stappen, de vier sub-agents, de testlus en het weglaten van falende tools, de vergelijking op 15 plus 15 vragen met Claude met toegang tot de repository en met Biomni, de verhoudingen in looptijd, en de genoemde beperkingen. Code: Paper2Agent op GitHub, MIT-licentie. De interpretatie in secties 3 tot en met 6 is van mij. Over wat MCP dit jaar verandert, zie MCP was gebouwd voor een mens achter een laptop. Over waarom een agent die alles leest meer kost dan je denkt, zie elk bestand dat je agent leest, blijft op de rekening staan.

IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.