Microsoft はリーダーなしで1,024のコーディングエージェントを動かした。128倍のエージェントで得たのは9.5ポイント

By Surya Pratap
2026年9月29日
9 min read
AI & Technology

2026年9月29日
9 min read
 エージェントを増やすと、主に速くなるHover to explore
多数のコーディングエージェントを動かすとき、よくあるのは一体を責任者に据えるやり方だ。プランナーが作業を分割して配る。だがワーカーの数がプランナーの追える範囲を超えた瞬間、そのプランナーがボトルネックになる。先週公開された Microsoft Research の論文は、プランナーを完全に取り除き、結果を1,024エージェントまでスケールさせた。設計は研究する価値がある。見出しの数字は注意して読む必要がある。
以下の内容はすべて、Microsoft Research の Zhihao Zhan、Ting Song、Li Dong、Shaohan Huang、Jianxun Lian、Yan Xia、Furu Wei による "Agensh: Scaling Organizational Intelligence to 1,024 Agents"(2026年9月22日に arXiv で公開)に基づく。査読前のプレプリントである。第3節以降の解釈は筆者のものである。
ProgramBench は、エージェントにコンパイル済みのプログラムを渡し、6時間以内、インターネット接続なし で、そのソフトウェアをゼロから作り直すよう求める。つまり、コンパイルでき、同じように動く完全なコードベースを作ることだ。スコアは、作り直したプログラムが通過した隠しテストの割合である。
Agensh は、ProgramBench の200タスクのうち、現行モデルの成績が最も悪い 最難関の5タスク で試された。対象はマルチメディア処理、分子シミュレーション、文書変換、言語の解釈、コードのインデックス作成にわたる。ワーカーはすべて同じモデル、推論負荷を高く設定した GPT-5.6-sol を使った。
5タスクでのテストの平均合格率:
| エージェント数 | 平均合格率 | 前の行からの変化 |
|---|---|---|
| 1 | 19.31% | — |
| 8 | 20.68% | +1.37ポイント |
| 32 | 26.52% | +5.84ポイント |
| 128 | 28.78% | +2.26ポイント |
1エージェントから128エージェントで約 9.5ポイント であり、著者はこれを 約49%の相対的な改善 と説明している。
1,024エージェントすべてで実行されたのは、文書変換ツール pandoc の1タスクだけだ。
128での実行の8倍のエージェントを投入して、試した唯一のタスクで上がったのは約 4ポイント だった。
曲線は上がる。ただしゆっくりで、一段上がるたびに、前の段よりはるかに多くのエージェントが必要になる。
論文で最も実用的な数字は最終スコアではない。各構成がどれだけ早く役に立つ水準に達したかだ。著者によれば、128エージェントは30分の時点でテスト合格率30%を超えた。32エージェントでは60分、8エージェントでは90分かかった。
並列化が確実に買えるのはこれだ。ある水準に早く到達すること。上限も動いたが、動きは小さい。実用的な水準に達するまでの時間は大きく動いた。
創業者にとって、この区別は重要だ。本来なら待てる仕事の所要時間を短くするためにお金を払うのなら、エージェントを増やすことはレイテンシーを買うことであり、値段をつけられる。一体では解けない問題をエージェントを増やせば解けると期待しているなら、この論文は、その効果はあるものの、追加したエージェントの数に比べて小さいことを示している。
真似する価値があるのは設計であり、規模から想像するより単純だ。共有される部品は三つある。
共有ワークスペース。 git サーバーである。各ワーカーは自分のチェックアウトとブランチを持ち、メインブランチにマージする。git は誰が何を変えたかを記録し、マージの競合を検出する。マージが競合で止まったら、ワーカーは他者の最新の作業を取り込み、競合を解消して、もう一度マージする。
メッセージインターフェース。 タスクごとの共有チャネルとダイレクトメッセージで、非同期に届き、履歴も残る。ワーカーは誰が何を担当するかを決め、依存関係を解きほぐす。
共有コンテキスト。 OBSERVED、FACT、FAIL、CLAIM、PATCH_SUMMARY といった型つきの項目を追記していくだけのログで、どのワーカーも検索できる。作業を始める前に、ワーカーは担当する範囲を書いた CLAIM を投稿する。
各ワーカーは同じループを回す。共有コンテキストを読み、作業の一部を宣言し、それをこなし、その部分の受け入れ基準と照合し、マージして、何をなぜ変えたかを公開する。ロックはない。重複は宣言と話し合いで処理する。
一つの細部が、協調の本当のコストがどこにあるかを示している。誰が何を担当するかをめぐる衝突を減らす ため、著者たちはすべてのエージェントを同時には起動しなかった。最初の1時間は30秒ごとに1体、その後は3秒ごとに1体 起動した。自己組織化を前提に組まれた設計でさえ、参加のタイミングは管理する必要があったということだ。
著者たちは、集団が大きくなるにつれて現れた振る舞いも記述している。8エージェントでは、ワーカーがインターフェースに合意し、それぞれが独立に実装した。128では、関連するコードを扱った経験に基づいてレビュアーを選んだ。1,024では、複数のワーカーが統合役を担い、他者が途中で放棄したタスクを引き継ぐワーカーも現れた。
論文は、どの実行のコストも公表していない。トークンの総量も、API の支出も、1ポイント上げるのに要した計算量もない。示されているのはワーカーごとの上限、つまり 入力27万2,000トークン、出力12万8,000トークン と6時間の予算だけだ。
これが重要なのは、スケーリングの主張が実は価格の主張だからだ。「128倍のエージェントで9.5ポイント」がよい取引かどうかは、128倍のコストがわかって初めて判断できる。それがなければ、結果が示すのはエージェントを増やせば役立つことがあるということであり、それが割に合うということではない。筆者はトークンの上限からコストを推定することはしない。ワーカーが上限まで使うとは限らず、推定値は実際より正確に見えてしまうからだ。
エージェントのスケーリング結果に投げかけるべき問い
「スコアは上がったか」ではなく、「各段階で1ドルあたり何ポイントか、そして何分短縮されたか」。次の倍増にお金を払う価値があるかを決めるのは、この二つの数字だ。
この設計を使うのに1,024エージェントは要らない。ほとんどは、2体以上を動かした時点で役に立つ。
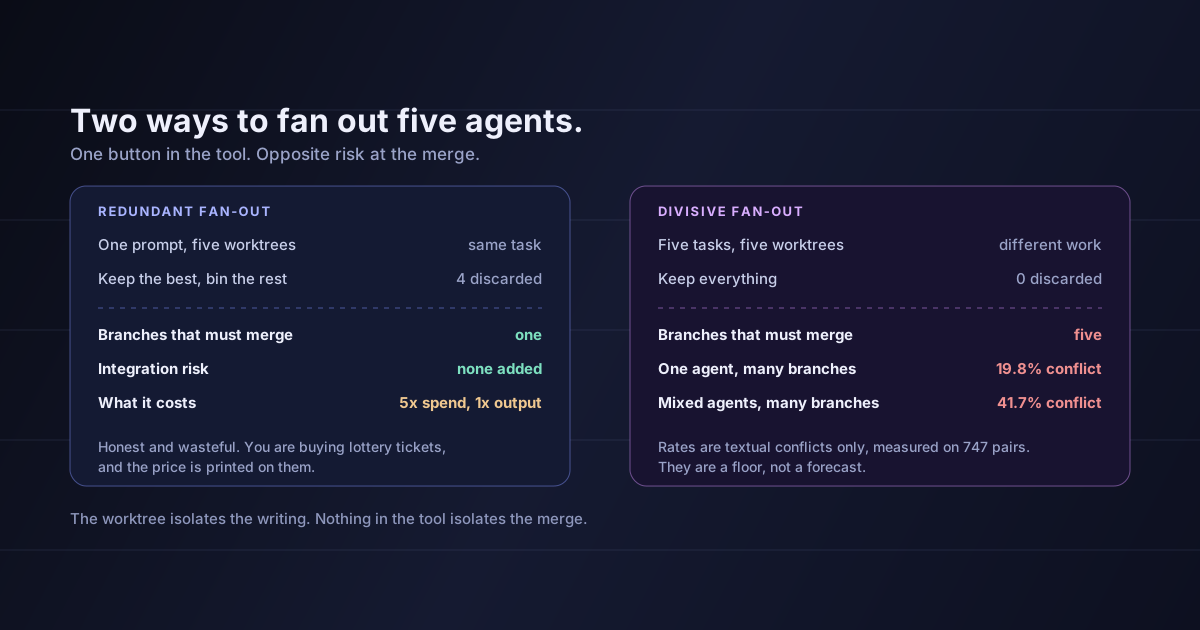
各エージェントは、始める前に何を担当するかを書き残す。5つのコーディングエージェントに作業を振り分けることを扱った以前の記事では、エージェントを隔離するのは簡単で、ぶつかるのはその成果を統合するときだと結論づけた。2026年のある研究では、エージェントのプルリクエストの27.67%でテキストのマージ競合が起きていた。作業を始める前に見える形で宣言することは、衝突と重複作業の両方を減らす最も安上がりな方法だ。
FAIL の項目があれば、後から来るエージェントが同じ行き止まりを繰り返さずに済む。ログの中で最も価値のある行であり、多くの構成が記録していない行でもある。
個別のブランチ、一つのメインブランチ、そして競合は引き起こしたエージェントが解消する。このインフラはすでに手元にあり、誰が何をしたかもすでに記録している。
Agensh のワーカーは、マージの前にサブタスクの基準と照らして作業を確認する。基準がなければ、「完了」はエージェントが決めたとおりの意味になってしまう。
Microsoft がこの規模で起動の間隔を空ける必要があったのなら、同じ空のタスクリストを同時に読む5体のエージェントもぶつかる。起動の間に少し間を置くのはタダだ。
自分たちの仕事で、1体、2体、4体のそれぞれが「十分によい」水準に達するまでの時間を記録する。これとコストを合わせれば、どこでエージェントの追加をやめるべきかがわかる。
これはプレプリントである。 査読を受けておらず、結果は一つのチームが一つのベンチマークで得たものだ。
対象は5タスクと1モデルである。 しかも1,024エージェントで実行されたのは1タスクだけだ。このパターンがほかのタスクやモデルでも成り立つとは限らない。
オーケストレーターとの比較がない。 論文は中央のオーケストレーターが協力を制限すると主張しているが、同じタスクで Agensh をオーケストレーター方式のシステムと比較してはいない。リーダーを取り除いたことが向上の原因なのかは、この論文からはわからない。
ばらつきのデータは見つからなかった。 32から128エージェントへの上昇が実行ごとのノイズより大きいかどうかは、公表された内容からは確認できない。
ProgramBench には、並外れて明確な正解がある。 エージェントはいつでも参照プログラムを実行して出力を比べられる。現実のソフトウェア開発のほとんどにはそのような判定役がなく、検証ははるかに難しい。「正しい」が判断に委ねられる場面では、この設計はうまくスケールしないかもしれない。
コストは不明である。 第5節は欠けたデータへの不満であり、向上が高すぎるという結論ではない。
Agensh は、中央のリーダーでは手に負えない規模でも、コーディングエージェントが協調できることを示した。使ったのは、ほとんどのチームがすでに持っているインフラ、つまり git、メッセージチャネル、共有ログだ。この設計は5エージェントでも役に立ち、ほとんどは無料で取り入れられる。
スケーリングの結果は見出しより控えめだ。1体から128体への増加で、最難関タスクのスコアは約9.5ポイント上がった。128から1,024への増加では、試した唯一のタスクで約4ポイントだった。最も明確な成果は速度だった。そして論文は、そのどれかにお金を払う価値があるのかを判断するための、唯一の数字を載せていない。
今週、宣言のログと失敗のログを取り入れること。エージェントを増やす前に、1体追加するごとに何が得られるかを、分とお金の両方で測ること。
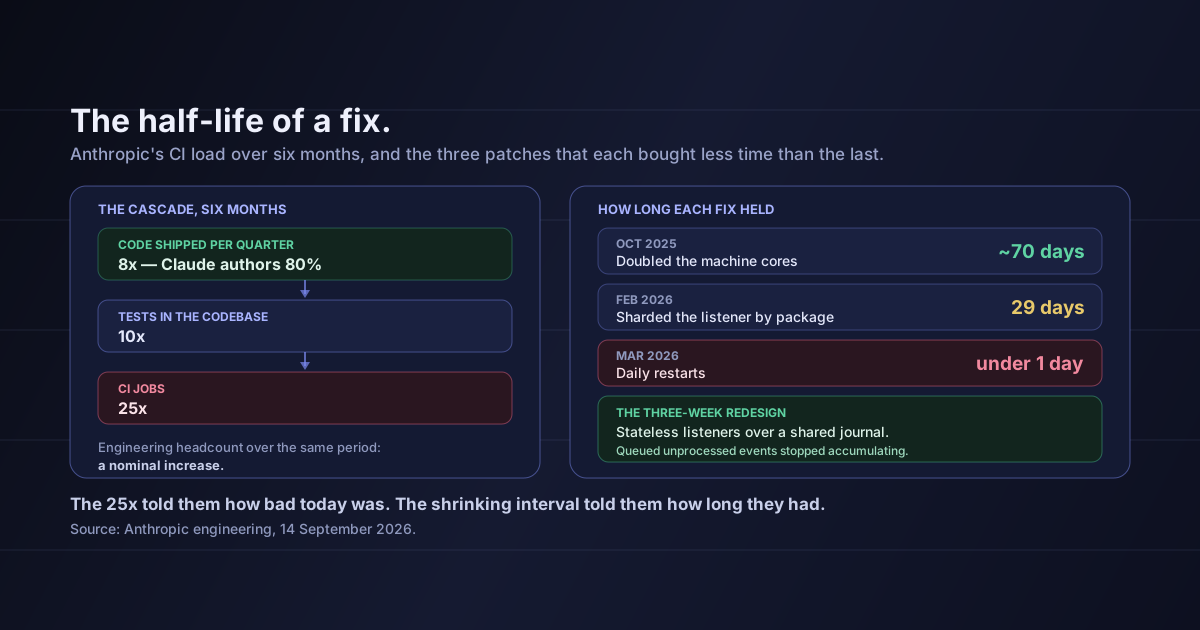
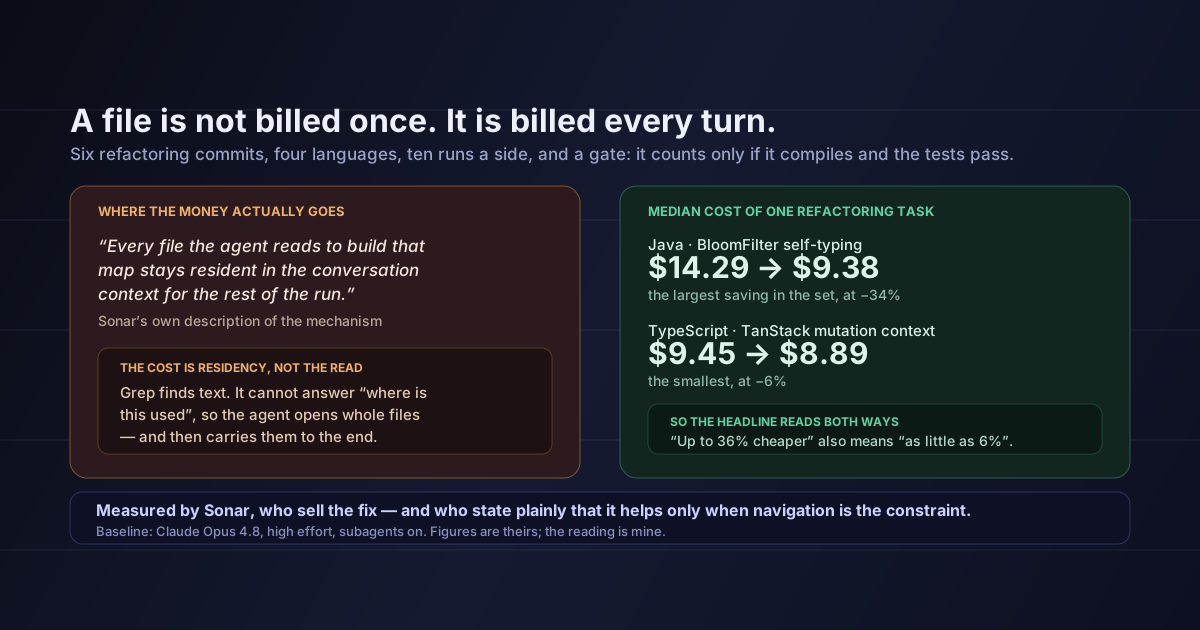
出典:Zhihao Zhan、Ting Song、Li Dong、Shaohan Huang、Jianxun Lian、Yan Xia、Furu Wei、"Agensh: Scaling Organizational Intelligence to 1,024 Agents"、Microsoft Research、arXiv:2609.26781v1、2026年9月22日。ProgramBench の設定、5タスクの選定、モデルとトークンの上限、19.31%、20.68%、26.52%、28.78%というテストの平均合格率、33.89%、50.94%、55.06%という pandoc の数字、約49%の相対的な改善、しきい値到達までの30分・60分・90分、インフラの三つの構成要素と型つきのコンテキスト項目、段階的な起動スケジュール、創発的な振る舞いは、すべて同論文の記載どおりである。第2節のポイント差は、これらの数字から筆者が計算したものである。第3節から第6節の解釈は筆者のものである。少数のコーディングエージェントに作業をどう振り分けるかという前段の問いについては5つのコーディングエージェントに作業を振り分ける二つの方法を、すべてを読むエージェントが見た目より高くつく理由についてはエージェントが読んだファイルはすべて請求書に残るを参照。
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.