
74 articles scientifiques sur 100 sont devenus des agents opérationnels. Les outils venaient des tutoriels, pas du code

By Surya Pratap
27 septembre 2026
9 min read
AI & Technology

27 septembre 2026
9 min read
 Construit à partir de ce qui tourneHover to explore
La plupart des tentatives pour rendre un dépôt de code utilisable par un agent partent du code : on pointe le modèle sur le dépôt et on le laisse deviner quoi appeler. Un article publié ce mois-ci dans Nature fait quelque chose de plus étroit, et ses résultats suggèrent que c'est cette approche plus étroite qu'il faut copier.
Paper2Agent a été publié dans Nature le 16 septembre 2026 par Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard et James Zou. L'article de Nature est payant ; les chiffres publiés que j'utilise viennent donc de deux résumés d'AI Weekly qui concordent sur ces chiffres. Le détail du pipeline et la comparaison avec d'autres systèmes viennent de la prépublication de 2025 des mêmes auteurs, une version antérieure du travail, et je précise à chaque fois de quelle source il s'agit. Le code est open source. L'interprétation, à partir de la section 3, est la mienne.
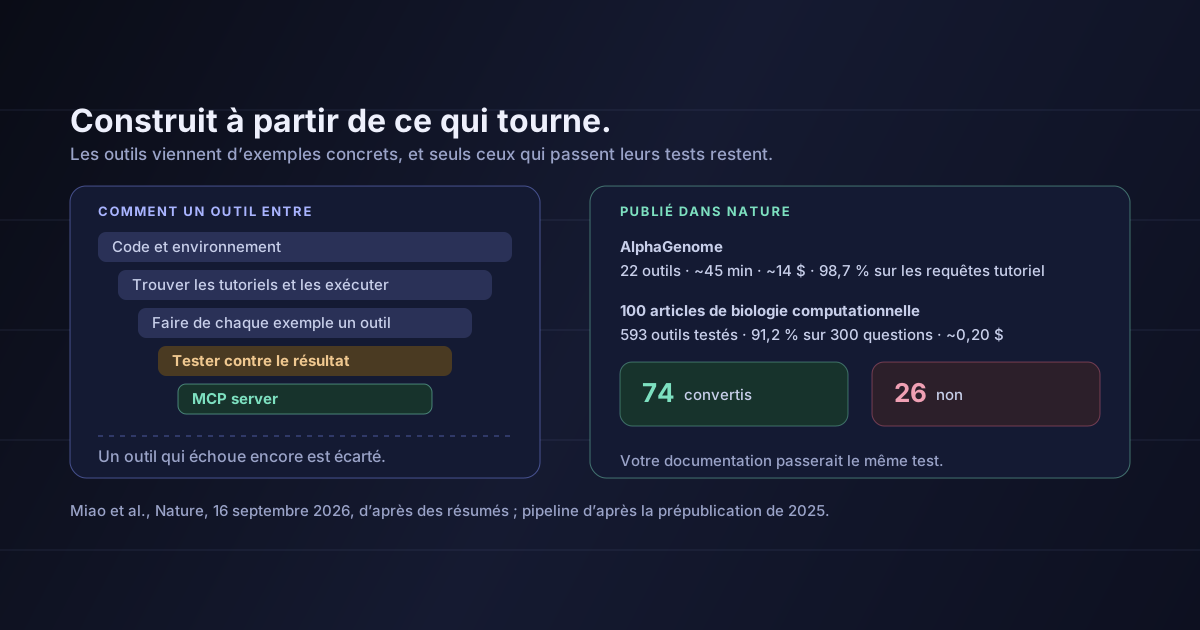
Paper2Agent prend un article scientifique et son code, et produit un serveur Model Context Protocol (MCP) : un ensemble d'outils que tout assistant compatible MCP peut appeler, chacun appliquant une méthode de l'article à de nouvelles données.
La prépublication décrit six étapes : localiser le code, préparer son environnement, trouver ses tutoriels, les exécuter, transformer chaque exemple concret en outil, puis assembler les outils en serveur. Quatre sous-agents se répartissent le travail : l'un gère l'environnement, un autre cherche les tutoriels, un troisième transforme les tutoriels en fonctions, et le dernier écrit et exécute les tests.
L'essentiel, ce sont les tests. Chaque outil extrait est testé contre le résultat du tutoriel lui-même, dans une boucle où l'on écrit des tests, les exécute, diagnostique les échecs et corrige. Le critère de la prépublication est que l'outil reproduise les résultats d'origine. Un outil qui continue d'échouer est écarté du serveur.
Il n'enveloppe pas tout ce que contient le dépôt. Il enveloppe ce qui fonctionne de façon démontrée, et écarte le reste.
D'après les résumés de la version parue dans Nature :
La prépublication, parue un an plus tôt, comparait un agent AlphaGenome à deux alternatives sur 15 requêtes issues des tutoriels et 15 nouvelles. L'agent de l'article a répondu correctement aux 30. Claude, avec un accès direct au dépôt, a réussi 9 sur 15 requêtes de tutoriel et 12 sur 15 nouvelles. Biomni, un agent biomédical généraliste, 6 sur 15 et 9 sur 15. L'agent de l'article était aussi plus rapide, de 1,8 à 4,6 fois selon la comparaison.
La comparaison, avec la taille de son échantillon
Quinze requêtes par condition, c'est peu, et ce chiffre vient de la prépublication, pas de la version publiée. Les chiffres publiés pour la même étude de cas sont un peu différents. J'utilise la comparaison pour sa direction — une couche d'outils testés a battu l'accès direct au dépôt — et non pour son ampleur exacte.
Un agent pointé sur un dépôt brut doit déterminer, à chaque requête, quelle fonction compte, quels arguments sont valides, dans quel ordre les choses s'exécutent, et laquelle des trois fonctions utilitaires presque identiques est celle que les auteurs ont réellement utilisée. Il peut être bon à cet exercice et se tromper souvent malgré tout, parce que le dépôt ne dit pas quels chemins sont les bons.
Un tutoriel, si. C'est la déclaration de l'auteur lui-même : voici comment la méthode est censée être utilisée, avec ses entrées, la séquence d'appels et le résultat attendu. Transformer les tutoriels en outils donne à l'agent un petit ensemble d'opérations qui ont déjà une bonne réponse connue. Tester chaque outil contre cette réponse transforme une supposition en quelque chose de vérifié.
C'est le même schéma qui fait qu'en production, de petits outils bien définis battent de grands outils généralistes : moins de choix, chacun vérifié. Ce que Paper2Agent apporte, c'est une façon de produire cette couche automatiquement, à partir d'un matériau que la plupart des projets possèdent déjà.
Les résumés n'expliquent pas les échecs, et je ne vais pas faire de suppositions article par article. La section limites de la prépublication est générale, mais claire : les articles dont le code est incomplet, mal documenté ou sujet aux erreurs ne peuvent pas être convertis de façon fiable.
Rapproché du fonctionnement du pipeline, cela décrit un test auquel votre propre produit serait soumis. Si vos exemples ne s'exécutent pas depuis un environnement vierge, il n'y a rien à extraire. S'ils s'exécutent mais que personne n'a noté le résultat attendu, il n'y a rien contre quoi tester. Si la seule documentation est une référence d'API, l'agent en est réduit à deviner quels appels comptent.
La vraie question pour un fondateur n'est donc pas « devons-nous créer un serveur MCP ? », mais :
Si quelqu'un faisait tourner ce pipeline sur votre dépôt public demain, combien d'outils testés et fonctionnels en sortiraient ?
Rendez chaque tutoriel exécutable depuis zéro. Une commande pour préparer l'environnement, pas d'état caché, pas de « puis configurez vos identifiants d'une manière ou d'une autre ». Un tutoriel qui ne fonctionne que sur l'ordinateur de son auteur ne sert d'exemple à personne, ni à un humain ni à un agent.
Notez le résultat attendu. Un exemple sans son résultat est une suggestion. Avec son résultat, c'est un test. Ce seul changement permet à n'importe quel pipeline automatique — ou à votre propre CI — de distinguer un outil qui fonctionne d'un outil qui en a seulement l'air.
Construisez votre serveur MCP à partir des exemples, pas de la référence. Exposer tous les endpoints donne à l'agent une vaste surface sur laquelle deviner. Exposer les dix tâches que montrent vos tutoriels, chacune testée, lui donne une petite surface qui fonctionne. L'étendue peut venir ensuite.
Testez les outils, pas seulement le serveur. Un serveur qui démarre n'est pas un serveur qui fonctionne. Gardez un test par outil qui vérifie qu'il reproduit toujours le résultat de son tutoriel, et lancez-le à chaque version, car votre API va changer et les outils vont dériver sans bruit.
L'argument du coût mérite aussi d'être noté. D'après les chiffres publiés, convertir l'une des études de cas a pris environ 45 minutes et 14 dollars, et chaque requête coûte environ 0,20 dollar. Quel que soit votre produit, une première version d'interface pour agents construite de cette façon n'est pas un projet d'un trimestre.
La même leçon vaut dans l'autre sens. Si votre agent doit utiliser une bibliothèque, un service interne ou le SDK d'un fournisseur, ne lui donnez pas le dépôt en croisant les doigts. Trouvez les exemples concrets, transformez chacun en outil étroit, testez chaque outil contre le résultat de l'exemple, et ne donnez à l'agent que ceux-là. La comparaison de la prépublication est modeste, mais elle va dans le même sens que l'essentiel de l'expérience en production : un agent qui choisit parmi quelques outils qui fonctionnent fait mieux qu'un agent qui choisit parmi tout ce qui existe.
Je n'ai pas lu l'article complet de Nature. Il est payant. Les chiffres publiés viennent de deux résumés du même média, AI Weekly, qui concordent sur tous les chiffres que j'utilise. La couverture n'est pas entièrement cohérente sur un autre chiffre concernant AlphaGenome, 82,7 %, qu'un résumé présente comme le score sur des questions ouvertes de chercheurs et un autre comme une comparaison avec un autre système ; je l'ai donc écarté. La description du pipeline et la comparaison viennent de la prépublication de 2025, une version antérieure qui donne des chiffres un peu différents.
Il s'agit de biologie computationnelle. Ses tutoriels et son code suivent des conventions partagées. On ne sait pas si le même taux de réussite tient pour du logiciel généraliste, où les exemples sont souvent moins soignés.
Des requêtes tirées des tutoriels favorisent des outils tirés des tutoriels. Un outil construit à partir d'un tutoriel réussira bien sur des questions issues de ce même tutoriel. Le banc de 300 questions et les nouvelles requêtes de la prépublication sont de meilleures preuves, et même celles-là ont été rédigées par les chercheurs.
L'analyse des échecs manque. Vingt-six des 100 articles n'ont pas été convertis, et les résumés ne disent pas pourquoi. Ma lecture de la section 4 s'appuie sur les limites générales de la prépublication, pas sur une analyse détaillée de ces 26 articles.
La comparaison est de petite taille. Quinze requêtes par condition, tirées de la prépublication. Elle montre une direction, pas un écart précis.
Le titre de Paper2Agent, c'est que des articles scientifiques peuvent devenir des agents. Pour les fondateurs, le résultat le plus utile est la méthode : non pas envelopper un dépôt de code, mais extraire les exemples concrets qui s'exécutent, tester chacun contre son résultat connu, et écarter les outils qui échouent.
La documentation devient alors quelque chose de plus proche d'une spécification d'interface. Les projets qui ont été convertis sont ceux dont les exemples pouvaient être exécutés et vérifiés. Les autres donnent une image assez fidèle de ce qui arrive à un produit dont les tutoriels ne sont plus à jour.
Exécutez vos propres tutoriels depuis un environnement vierge cette semaine, et notez ce que chacun est censé produire. C'est l'essentiel du travail pour rendre votre produit utilisable par des agents.
Sources : Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard et James Zou, « Reimagining research papers as interactive and reliable AI agents », Nature, 16 septembre 2026 — chiffres publiés d'après les résumés d'AI Weekly « Paper2Agent turns research papers into working AI agents » et « Paper2Agent converts research papers into callable AI agents » : les 22 outils, les 45 minutes et les 14 dollars, les 98,7 ± 1,3 % sur les requêtes tirées des tutoriels, les 74 articles sur 100, les 593 outils, les 91,2 ± 1,6 % sur 300 questions, les 0,20 dollar et 1,6 minute par requête. La prépublication des mêmes auteurs, « Paper2Agent: Reimagining Research Papers As Interactive and Reliable AI Agents », arXiv:2509.06917, v2 du 16 octobre 2025 — le pipeline en six étapes, les quatre sous-agents, la boucle de tests et l'exclusion des outils qui échouent, la comparaison sur 15 plus 15 requêtes avec Claude disposant du dépôt et avec Biomni, les rapports de temps d'exécution et les limites déclarées. Code : Paper2Agent sur GitHub, licence MIT. L'interprétation des sections 3 à 6 est la mienne. Sur ce que MCP change cette année, voir MCP a été conçu pour un humain devant son ordinateur. Sur les raisons pour lesquelles un agent qui lit tout coûte plus cher qu'on ne le pense, voir chaque fichier lu par votre agent reste sur la facture.

IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.