
74 de 100 artículos científicos se convirtieron en agentes funcionales. Las herramientas salieron de los tutoriales, no del código

By Surya Pratap
27 de septiembre de 2026
9 min read
AI & Technology

27 de septiembre de 2026
9 min read
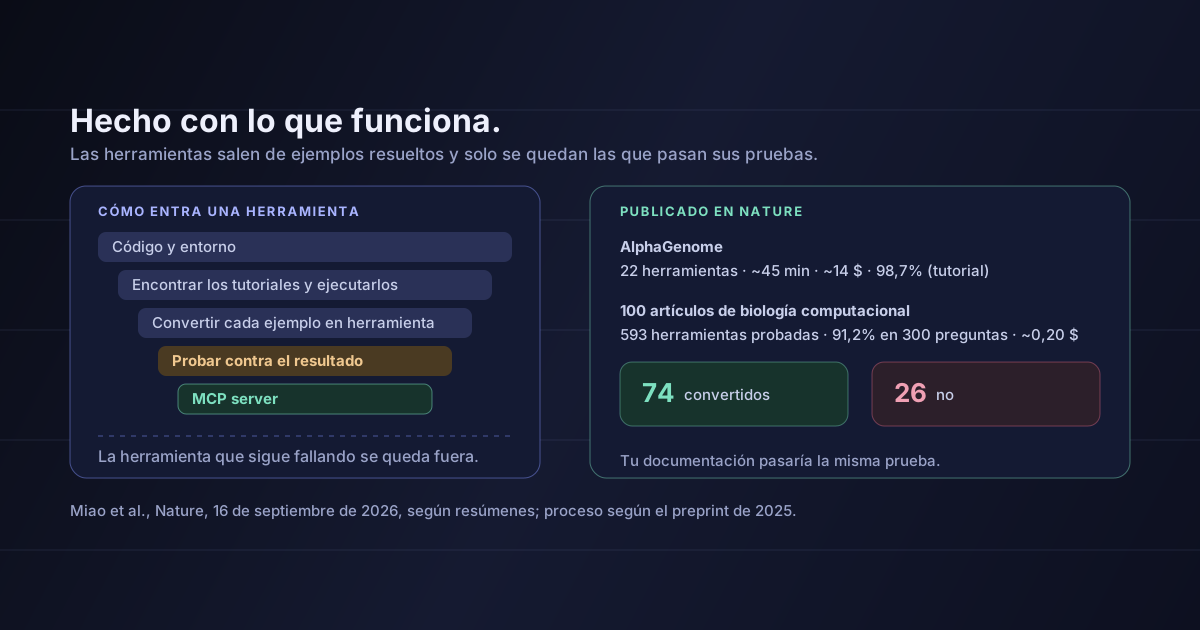 Hecho con lo que funcionaHover to explore
La mayoría de los intentos de hacer que un agente pueda usar un repositorio empiezan por el código: se apunta el modelo al repositorio y se le deja averiguar a qué llamar. Un artículo publicado este mes en Nature hace algo más acotado, y sus resultados indican que ese enfoque más acotado es el que conviene copiar.
Paper2Agent se publicó en Nature el 16 de septiembre de 2026, firmado por Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard y James Zou. El artículo de Nature es de pago, así que las cifras publicadas que uso proceden de dos resúmenes de AI Weekly que coinciden en esos números. Los detalles del proceso y la comparación con otros sistemas proceden del preprint de 2025 de los mismos autores, una versión anterior del trabajo, y siempre indico cuál es cuál. El código es de código abierto. La lectura a partir de la sección 3 es mía.
Paper2Agent toma un artículo científico y su código y produce un servidor Model Context Protocol (MCP): un conjunto de herramientas que cualquier asistente compatible con MCP puede invocar, cada una de las cuales aplica un método del artículo a datos nuevos.
El preprint describe seis pasos: localizar el código, preparar su entorno, encontrar sus tutoriales, ejecutarlos, convertir cada ejemplo resuelto en una herramienta y montar las herramientas en un servidor. Cuatro subagentes se reparten el trabajo: uno gestiona el entorno, otro busca los tutoriales, otro convierte los tutoriales en funciones y otro escribe y ejecuta las pruebas.
Lo importante son las pruebas. Cada herramienta extraída se prueba contra el resultado del propio tutorial, en un ciclo de escribir pruebas, ejecutarlas, diagnosticar los fallos y corregirlos. El listón del preprint es que la herramienta reproduzca los resultados originales. Una herramienta que sigue fallando se queda fuera del servidor.
No envuelve todo lo que hay en el repositorio. Envuelve lo que demostrablemente funciona y descarta el resto.
Según los resúmenes de la versión de Nature:
El preprint, publicado un año antes, comparó un agente de AlphaGenome con dos alternativas en 15 consultas de tutorial y 15 nuevas. El agente del artículo respondió bien las 30. Claude con acceso directo al repositorio acertó 9 de 15 consultas de tutorial y 12 de 15 nuevas. Biomni, un agente biomédico generalista, acertó 6 de 15 y 9 de 15. El agente del artículo fue además más rápido, entre 1,8 y 4,6 veces según la comparación.
La comparación, con su tamaño de muestra
Quince consultas por condición es poco, y la cifra procede del preprint, no de la versión publicada. Las cifras publicadas para el mismo caso son algo distintas. Uso la comparación por su dirección —una capa de herramientas probadas superó al acceso directo al repositorio—, no por su magnitud exacta.
Un agente apuntado a un repositorio en bruto tiene que deducir, en cada consulta, qué función importa, qué argumentos son válidos, en qué orden se ejecutan las cosas y cuál de las tres funciones auxiliares casi idénticas es la que usaron realmente los autores. Puede hacerlo bien y aun así equivocarse a menudo, porque el repositorio no dice qué caminos son los buenos.
Un tutorial sí lo dice. Es la declaración del propio autor de así es como se usa el método, con sus entradas, la secuencia de llamadas y el resultado esperado. Convertir tutoriales en herramientas le da al agente un conjunto pequeño de operaciones que ya tienen una respuesta correcta conocida. Probar cada herramienta contra esa respuesta convierte una suposición en algo comprobado.
Es el mismo patrón que hace que, en producción, las herramientas pequeñas y bien definidas superen a las grandes y generales: menos opciones, cada una verificada. Lo que aporta Paper2Agent es una forma de generar esa capa automáticamente a partir de un material que la mayoría de los proyectos ya tiene.
Los resúmenes no explican los fallos, y no voy a especular artículo por artículo. La sección de limitaciones del preprint es general, pero clara: los artículos con código incompleto, mal documentado o propenso a errores no se pueden convertir de forma fiable.
Si se pone eso al lado de cómo funciona el proceso, describe una prueba a la que se enfrentaría tu propio producto. Si tus ejemplos no se ejecutan desde un entorno limpio, no hay nada que extraer. Si se ejecutan pero nadie anotó el resultado esperado, no hay nada contra lo que probar. Si la única documentación es una referencia de la API, el agente vuelve a tener que adivinar qué llamadas importan.
Así que la pregunta práctica para un fundador no es «¿deberíamos crear un servidor MCP?», sino esta:
Si alguien ejecutara mañana este proceso sobre tu repositorio público, ¿cuántas herramientas probadas y funcionales saldrían?
Haz que cada tutorial se ejecute desde cero. Un comando para preparar el entorno, sin estado oculto, sin un «y luego configura tus credenciales como puedas». Un tutorial que solo funciona en el portátil de su autor no le sirve de ejemplo a nadie, ni a una persona ni a un agente.
Anota el resultado esperado. Un ejemplo resuelto sin su resultado es una sugerencia. Con su resultado, es una prueba. Ese único cambio es lo que permite a cualquier proceso automático —o a tu propia CI— distinguir una herramienta que funciona de una que solo lo parece.
Construye tu servidor MCP a partir de los ejemplos, no de la referencia. Exponer todos los endpoints le da al agente una superficie enorme sobre la que adivinar. Exponer las diez tareas que muestran tus tutoriales, cada una probada, le da una superficie pequeña que funciona. La amplitud puede venir después.
Prueba las herramientas, no solo el servidor. Que un servidor arranque no significa que funcione. Mantén una prueba por herramienta que compruebe que sigue reproduciendo el resultado de su tutorial, y ejecútala en cada versión, porque tu API cambiará y las herramientas se irán desviando sin avisar.
También merece atención el coste. Según las cifras publicadas, convertir uno de los casos llevó unos 45 minutos y 14 dólares, y cada consulta cuesta unos 0,20 dólares. Sea cual sea tu producto, una primera versión de una interfaz para agentes construida así no es un proyecto de un trimestre.
La misma lección vale desde el otro lado. Si tu agente necesita usar una biblioteca, un servicio interno o el SDK de un proveedor, no le des el repositorio y cruces los dedos. Busca los ejemplos resueltos, convierte cada uno en una herramienta acotada, prueba cada herramienta contra el resultado del ejemplo y dale al agente solo esas. La comparación del preprint es pequeña, pero apunta en la misma dirección que casi toda la experiencia en producción: un agente que elige entre unas pocas herramientas que funcionan rinde más que uno que elige entre todo lo que existe.
No he leído el artículo completo de Nature. Es de pago. Las cifras publicadas proceden de dos resúmenes del mismo medio, AI Weekly, que coinciden en todas las cifras que uso. La cobertura no es del todo coherente en otra cifra de AlphaGenome, un 82,7%, que un resumen presenta como el acierto en preguntas abiertas de investigadores y otro describe como una comparación con otro sistema, así que la he dejado fuera. La descripción del proceso y la comparación proceden del preprint de 2025, una versión anterior que da cifras algo distintas.
Esto es biología computacional. Sus tutoriales y su código siguen convenciones compartidas. No se ha probado si la misma tasa de éxito se mantiene con software general, donde los ejemplos suelen estar menos cuidados.
Las consultas derivadas de tutoriales favorecen a las herramientas derivadas de tutoriales. Una herramienta construida a partir de un tutorial rendirá bien en preguntas sacadas de ese mismo tutorial. El banco de 300 preguntas y las consultas nuevas del preprint son mejores pruebas, e incluso esas las escribieron los propios investigadores.
Falta el análisis de los fallos. Veintiséis de los 100 artículos no se convirtieron, y los resúmenes no dicen por qué. Mi lectura de la sección 4 usa las limitaciones generales del preprint, no un desglose de esos 26 artículos.
La comparación es pequeña. Quince consultas por condición, del preprint. Muestra una dirección, no una diferencia precisa.
El titular de Paper2Agent es que los artículos científicos pueden convertirse en agentes. Para los fundadores, el resultado más útil es el cómo: no envolviendo un repositorio, sino extrayendo los ejemplos resueltos que se ejecutan, probando cada uno contra su resultado conocido y descartando las herramientas que fallan.
Eso convierte la documentación en algo más parecido a una especificación de interfaz. Los proyectos que se convirtieron fueron aquellos cuyos ejemplos se podían ejecutar y comprobar. Los que no, son un retrato bastante fiel de lo que le pasa a un producto cuyos tutoriales se han quedado desfasados.
Ejecuta esta semana tus propios tutoriales desde un entorno limpio y anota qué debe devolver cada uno. Eso es la mayor parte del trabajo para que tu producto lo puedan usar los agentes.
Fuentes: Jiacheng Miao, Joe R. Davis, Yaohui Zhang, Jonathan K. Pritchard y James Zou, «Reimagining research papers as interactive and reliable AI agents», Nature, 16 de septiembre de 2026; cifras publicadas según los resúmenes de AI Weekly «Paper2Agent turns research papers into working AI agents» y «Paper2Agent converts research papers into callable AI agents»: las 22 herramientas, los 45 minutos y los 14 dólares, el 98,7 ± 1,3% en consultas de tutorial, los 74 de 100 artículos, las 593 herramientas, el 91,2 ± 1,6% en 300 preguntas, y los 0,20 dólares y 1,6 minutos por consulta. El preprint de los mismos autores, «Paper2Agent: Reimagining Research Papers As Interactive and Reliable AI Agents», arXiv:2509.06917, v2 del 16 de octubre de 2025: el proceso de seis pasos, los cuatro subagentes, el ciclo de pruebas y la exclusión de las herramientas que fallan, la comparación de 15 más 15 consultas con Claude con acceso al repositorio y con Biomni, las proporciones de tiempo de ejecución y las limitaciones declaradas. Código: Paper2Agent en GitHub, licencia MIT. La lectura de las secciones 3 a 6 es mía. Sobre lo que está cambiando MCP este año, ver MCP se diseñó para una persona delante de un portátil. Sobre por qué un agente que lo lee todo cuesta más de lo que parece, ver cada archivo que lee tu agente se queda en la factura.

IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.