A Meta diz que o Muse Spark 1.3 usa menos 25% de tokens. Os testes independentes dizem que a sua fatura subiu

By Surya Pratap
15 de setembro de 2026
12 min de leitura
IA e tecnologia

15 de setembro de 2026
12 min de leitura
 Duas versões do custo, uma faturaHover to explore
A Meta lançou o Muse Spark 1.3 a 2 de setembro de 2026, no Muse Code e na Meta Model API. O lançamento traz uma história de eficiência e uma história de benchmarks, e vale a pena ler cada uma duas vezes — não por alguma ser falsa, mas porque nenhuma diz bem aquilo que um fundador assumiria.
Muse Spark 1.3, tal como saiu
Disponível hoje; os pesos estão fechados
Duas dessas coisas são mesmo boas notícias. A janela de 1M é grande o suficiente para que «caberá?» deixe de ser a pergunta diária na maioria das bases de código, e manter o preço por token estável numa subida de capacidade é uma concessão a sério num mercado que, em geral, não a faz.
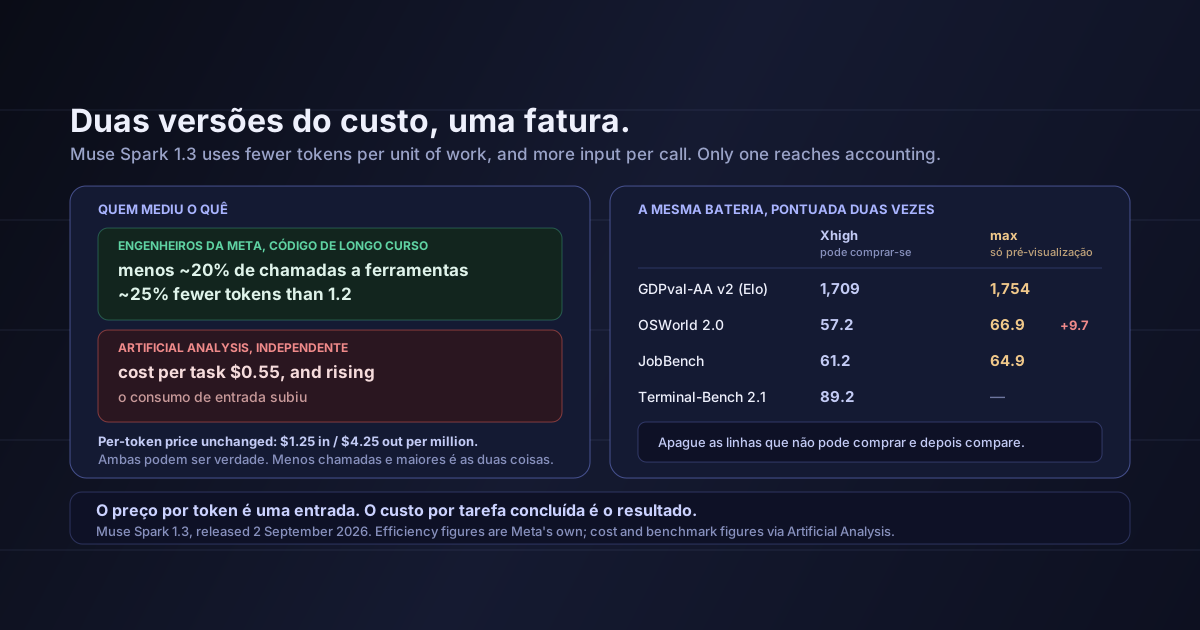
O título da Meta é que o 1.3 usa menos ~20% de chamadas a ferramentas e menos ~25% de tokens do que o Muse Spark 1.2.
A precisão importa: esses números vêm de avaliações feitas por engenheiros da Meta em tarefas de programação de longo curso. É uma comparação interna do fornecedor sobre uma carga de trabalho escolhida pelo fornecedor — nem inventada, nem auditada, nem necessariamente a sua.
Lida à letra é também uma afirmação mais estreita do que parece. Menos chamadas e menos tokens por unidade do trabalho que mediram. Se a sua fatura desce depende de uma quantidade que a Meta não reportou: quanto contexto leva cada uma das chamadas que restam.
A Artificial Analysis, em testes independentes, mediu um custo por tarefa de 0,55 dólares na configuração amplamente disponível — e reportou custos por tarefa a subir face ao 1.2 apesar do preço por token inalterado, porque o consumo de tokens de entrada aumentou.
Ponha as duas conclusões lado a lado e não se contradizem. Descrevem metades diferentes da mesma mudança.
Chamadas menos numerosas e maiores é ganho de eficiência por uma medida e subida de custo pela outra. Um modelo que pensa mais por passo dá menos passos e lê mais em cada um.
É a mesma aritmética do imposto de contexto. O trabalho com agentes fatura-se pelo que o modelo lê, não pelo número de vezes que para para pensar, e um harness que carrega mais contexto por chamada para justificar fazer menos chamadas pode consumir mais no total enquanto todos os números do título melhoram.
O número a pedir em qualquer anúncio de modelo
O preço por token é uma entrada, não um resultado. O único número que resolve uma decisão de mudança é o custo por tarefa concluída na sua carga de trabalho: a execução inteira, incluindo repetições, tentativas falhadas e o contexto que cada chamada levou. A Meta reportou rácios de eficiência; a Artificial Analysis reportou custo por tarefa. Quando esses dois apontam em sentidos opostos, é o segundo que chega à contabilidade.
Esta é a parte que quase toda a cobertura achatou, e muda como se deve ler a tabela.
O Muse Spark 1.3 foi avaliado em duas configurações. Uma pode comprar-se hoje. A outra não.
A diferença não é cosmética. No OSWorld 2.0 são 9,7 pontos — 57,2 contra 66,9 — e a configuração máxima apareceu em destaque nos materiais de lançamento apesar de não estar à venda.
Ninguém está exatamente a ser enganado: as configurações estão identificadas. Mas um fundador que percorre uma tabela comparativa vai ler o número mais alto da coluna do Muse e compará-lo com aquilo que tem hoje a correr, e essa comparação falha por cerca de dez pontos precisamente no benchmark que mais se parece com operar um computador.
Regra prática: em qualquer lançamento de modelo, procure a nota que diz sob que configuração cada coluna correu e apague todas as linhas que não pode comprar.
A linha de preços que mais merece ser pensada é a que parece o melhor negócio.
O padrão é 1,25 / 4,25 dólares por milhão de tokens. O nível contributor é 0,10 / 0,20 — cerca de 12x mais barato na entrada e 21x na saída — em troca de permitir que os seus dados sejam usados para treino.
Para um projeto paralelo sem produto, isso é inferência quase de graça e um sim fácil. Para qualquer coisa que leve dados de clientes é outra pergunta completamente diferente, e não é sobretudo uma pergunta de custo:
Nada disto torna o nível errado. A Meta é invulgarmente explícita sobre a troca, mais do que a maioria das ofertas de inferência com desconto. Significa apenas que a decisão pertence a quem detém os seus compromissos sobre dados, e não a quem vigia a fatura da inferência.
Três notas de contexto, todas com ressalvas.
O débito fica atrás. Com 235,2 tokens de saída por segundo, o Muse Spark 1.3 corre cerca de 30% mais devagar do que o Gemini 3.8 Flash. Em programação interativa isso sente-se; em trabalho noturno por lotes é praticamente irrelevante.
Pesos fechados, com um roteiro que não é um plano. A Meta menciona um lançamento do Muse Spark com pesos abertos entre «modelos maiores… e mais» — sem versão, sem data, sem condições de licença. Se a sua arquitetura depende de acabar a alojar por conta própria, essa frase não é algo sobre o qual construir. Compare com os harnesses que saíram abertos em agosto, onde a portabilidade era o produto e não uma intenção futura.
O leque de benchmarks é mesmo sólido onde é sólido. Terminal-Bench 2.1 em 89,2, DeepSearchQA em 89,4, recuperação em contexto longo em 98,5 para 256K–512K e 98,1 para 512K–1M. É este último par que eu mais pesaria, porque uma qualidade de recuperação quase plana ao longo de uma janela de 1M é o que torna um contexto grande digno de se pagar em vez de ser apenas grande.
Uma ressalva sobre os números: os valores publicados de Terminal-Bench 2.1 para o 1.3 variam ligeiramente conforme a fonte — 89,2 na tabela da Artificial Analysis e 88,8 noutros sítios. É uma diferença ao nível do arredondamento, sem consequência para decisão nenhuma, mas quando as fontes divergem a regra da casa é dizê-lo.
Se hoje corre uma carga de trabalho de programação com agentes, isto é uma experiência de duas horas e não um exercício de leitura.
Como eu avaliaria a atualização a sério
A comparação tem de ser por tarefa concluída, não por token
Os números de eficiência internos do fornecedor não são falsos, são estreitos. «Engenheiros da Meta mediram-no em tarefas de programação de longo curso» é uma metodologia declarada e mais do que muitos lançamentos dão. Continua a ser a carga de trabalho deles e o harness deles.
Uma única medição independente de custo também não é a última palavra. A Artificial Analysis corre uma bateria fixa de tarefas; o seu repositório não é essa bateria. A razão para confiar no enquadramento do custo por tarefa não são os 0,55 dólares concretos — é que a métrica é a certa.
Uma configuração de raciocínio máximo em pré-visualização é normal. Lançar por fases depois de testes de segurança é prática razoável, e o incómodo aqui é de apresentação e não ético: os números foram mostrados em materiais dirigidos a pessoas que ainda não os conseguem obter.
Um salto de versão não é uma migração. O 1.2 continua a funcionar, continua a custar o mesmo por token, e mudar um agente em produção para um modelo afinado sobre outro comportamento de longo curso vai alterar a forma como os seus prompts se comportam de maneiras que nenhum benchmark prevê.
O Muse Spark 1.3 é uma melhoria a sério, lançada sem subir o preço por token, dentro de um harness que já há gente a correr, com uma janela de 1M cuja qualidade de recuperação aguenta ao longo de toda a janela. É um bom lançamento.
Chega também com dois números a apontar em sentidos opostos — menos tokens por unidade de trabalho pela contagem do fornecedor, custo por tarefa mais alto por uma contagem independente — e com uma tabela cuja coluna mais brilhante é uma configuração que ninguém pode ainda comprar. Nenhuma destas coisas é um escândalo. Ambas são banais, e ambas são exatamente aquilo que decide se a sua fatura de inferência em novembro bate certo com o plano que escreveu em setembro.
O preço por token não lhe disse nada esta semana. O custo por tarefa concluída, nas suas próprias tarefas, teria dito.
Fontes: Meta AI Research, "Introducing Muse Spark 1.3" · VentureBeat, "Meta says Muse Spark 1.3 has frontier performance — but its best results come from a model developers can't broadly use yet" · MarkTechPost, "Meta AI Released Muse Spark 1.3" · Os números de eficiência de ~20%/~25% são da Meta, a partir de avaliações feitas por engenheiros da Meta em tarefas de programação de longo curso. As pontuações de benchmarks, o custo por tarefa de 0,55 dólares, o débito de 235,2 tokens por segundo e a separação entre Xhigh e máximo são os reportados pela Artificial Analysis via VentureBeat; a configuração máxima estava em pré-visualização limitada a parceiros à data dos testes. Onde os números de Terminal-Bench 2.1 divergem entre fontes, isso é assinalado na secção 6. A leitura das duas afirmações de custo como compatíveis, e todas as recomendações, são minhas. Para o harness dentro do qual este modelo corre, veja os dois harnesses de agentes que saíram com um dia de diferença.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.