Meta zegt dat Muse Spark 1.3 25% minder tokens gebruikt. Onafhankelijke tests zeggen dat je rekening steeg

By Surya Pratap
15 september 2026
12 min leestijd
AI en technologie

15 september 2026
12 min leestijd
 Twee kostenverhalen, één factuurHover to explore
Meta bracht Muse Spark 1.3 uit op 2 september 2026, in Muse Code en de Meta Model API. De lancering heeft een efficiëntieverhaal en een benchmarkverhaal, en allebei zijn ze het dubbel lezen waard — niet omdat er een onwaar is, maar omdat geen van beide precies zegt wat een founder redelijkerwijs zou aannemen.
Muse Spark 1.3, zoals uitgebracht
Vandaag beschikbaar; de gewichten zijn gesloten
Twee daarvan zijn echt goed nieuws. Het venster van 1M is groot genoeg dat "past het erin" voor de meeste codebases niet langer de dagelijkse vraag is, en de prijs per token vlak houden bij een capaciteitsupgrade is een echte concessie in een markt die dat meestal niet doet.
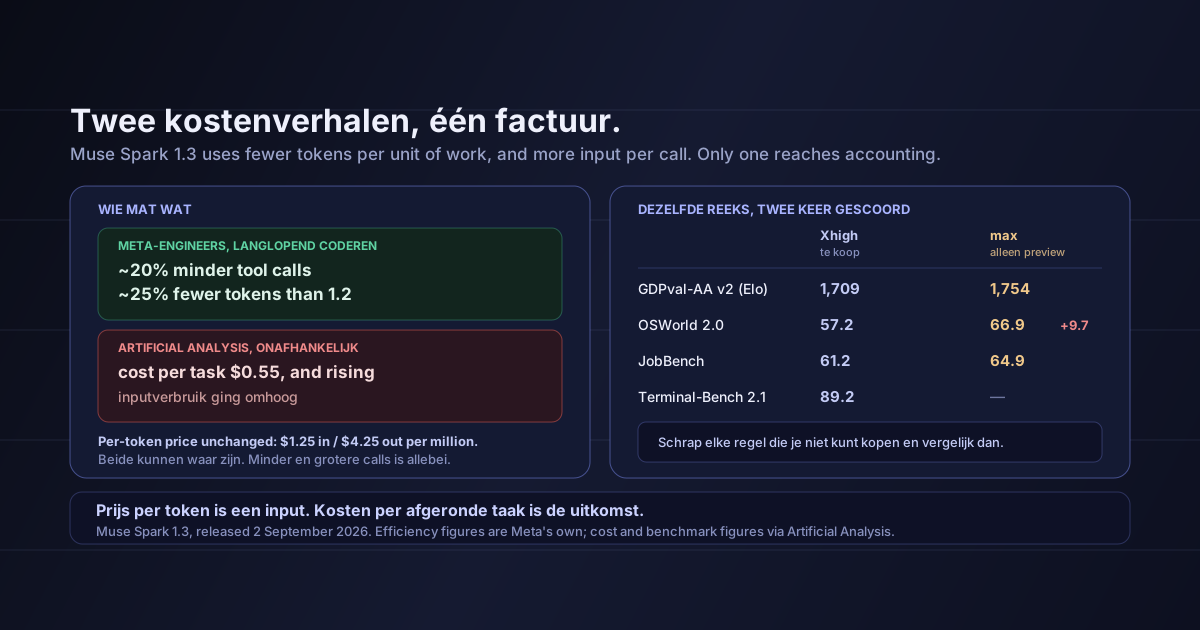
Meta's kop is dat 1.3 ~20% minder tool calls en ~25% minder tokens gebruikt dan Muse Spark 1.2.
De precisie doet ertoe: die cijfers komen uit evaluaties door Meta-engineers op langlopende codeertaken. Dat is een interne vergelijking van de leverancier op een door de leverancier gekozen workload — niet verzonnen, niet geauditeerd, en niet per se de jouwe.
Letterlijk gelezen is het ook een smallere claim dan hij klinkt. Minder tool calls en minder tokens per eenheid van het werk dat zij hebben gemeten. Of jouw rekening daalt, hangt af van een grootheid die Meta niet rapporteerde: hoeveel context elk van die overgebleven calls meedraagt.
Artificial Analysis mat onafhankelijk $0,55 aan kosten per taak op de breed beschikbare configuratie — en rapporteerde dat de taakkosten ten opzichte van 1.2 stegen ondanks de ongewijzigde prijs per token, omdat het verbruik van inputtokens toenam.
Leg de twee bevindingen naast elkaar en ze spreken elkaar niet tegen. Ze beschrijven verschillende helften van dezelfde verandering.
Minder en grotere calls is volgens de ene maatstaf efficiëntiewinst en volgens de andere een kostenstijging. Een model dat per stap harder nadenkt, zet minder stappen en leest er bij elke stap meer bij.
Dit is dezelfde rekensom als de contextbelasting. Agentisch werk rekent af op wat het model leest, niet op hoe vaak het stopt om na te denken, en een harness die meer context per call laadt om minder calls te rechtvaardigen, kan in totaal meer verbruiken terwijl elk kopcijfer verbetert.
Het cijfer waar je om vraagt bij elke modelaankondiging
Prijs per token is een input, geen uitkomst. Het enige cijfer dat een overstapbeslissing beslecht, is de kosten per afgeronde taak op jouw workload: de hele run, inclusief herkansingen, mislukte pogingen en de context die elke call meedroeg. Meta rapporteerde efficiëntieratio's; Artificial Analysis rapporteerde kosten per taak. Wijzen die twee tegengesteld, dan is de tweede degene die bij de boekhouding aankomt.
Dit is het deel dat de meeste berichtgeving platsloeg, en het verandert hoe je de scorekaart moet lezen.
Muse Spark 1.3 is in twee configuraties geëvalueerd. Eén kun je vandaag kopen. De andere niet.
Het gat is niet cosmetisch. Op OSWorld 2.0 is het 9,7 punten — 57,2 tegen 66,9 — en de max-configuratie stond prominent in het lanceringsmateriaal terwijl je haar niet kunt kopen.
Niemand wordt hier precies misleid; de configuraties zijn gelabeld. Maar een founder die een vergelijkingstabel doorneemt, leest het hoogste getal in de Muse-kolom en vergelijkt dat met wat hij vandaag draait, en die vergelijking zit er zo'n tien punten naast op juist de benchmark die het meest lijkt op het bedienen van een computer.
Vuistregel: zoek bij elke modellancering de voetnoot die zegt onder welke configuratie elke kolom draaide, en schrap elke regel die je niet kunt kopen.
De prijsregel die het meeste nadenken verdient, is degene die eruitziet als de beste deal.
Standaard is $1,25 / $4,25 per miljoen tokens. Het contributor-tier is $0,10 / $0,20 — ongeveer 12x goedkoper op input en 21x op output — in ruil voor toestemming om je data voor training te gebruiken.
Voor een zijproject zonder product is dat vrijwel gratis inferentie en een makkelijke ja. Voor alles wat klantdata draagt, is het een heel andere vraag, en het is in de eerste plaats geen kostenvraag:
Niets daarvan maakt het tier verkeerd. Meta is ongewoon expliciet over de ruil, explicieter dan de meeste aanbiedingen voor goedkope inferentie. Het betekent alleen dat de beslissing hoort bij wie je dataverplichtingen bezit, niet bij wie de inferentierekening in de gaten houdt.
Drie stukjes context, alle drie met voorbehoud.
De doorvoer blijft achter. Met 235,2 outputtokens per seconde draait Muse Spark 1.3 ongeveer 30% trager dan Gemini 3.8 Flash. Bij interactief coderen voel je dat; bij nachtelijk batchwerk is het vrijwel irrelevant.
Gesloten gewichten, met een roadmap die geen plan is. Meta noemt een open-weights-uitgave van Muse Spark tussen "grotere modellen… en meer" — geen versie, geen datum, geen licentievoorwaarden. Hangt je architectuur ervan af dat je uiteindelijk zelf host, dan is die zin niets om op te bouwen. Vergelijk met de harnesses die in augustus open uitkwamen, waar de portabiliteit het product was in plaats van een toekomstige intentie.
De benchmarkspreiding is echt sterk waar hij sterk is. Terminal-Bench 2.1 op 89,2, DeepSearchQA op 89,4, langecontext-retrieval op 98,5 voor 256K–512K en 98,1 voor 512K–1M. Dat laatste paar zou ik het zwaarst wegen, want vrijwel vlakke retrievalkwaliteit over een venster van 1M is wat een groot context het betalen waard maakt in plaats van alleen groot.
Eén kanttekening bij de cijfers: gepubliceerde Terminal-Bench 2.1-waarden voor 1.3 verschillen licht per bron — 89,2 in de tabel van Artificial Analysis en 88,8 elders. Het is een afrondingsverschil zonder gevolg voor welke beslissing dan ook, maar waar bronnen van elkaar afwijken is de huisregel dat te zeggen.
Draai je vandaag een agentische codeerworkload, dan is dit een experiment van twee uur in plaats van een leesoefening.
Hoe ik de upgrade werkelijk zou beoordelen
De vergelijking moet per afgeronde taak zijn, niet per token
Interne efficiëntiecijfers van een leverancier zijn niet onjuist, ze zijn smal. "Meta-engineers maten het op langlopende codeertaken" is een openbaar gemaakte methode en meer dan veel lanceringen geven. Het blijft hun workload en hun harness.
Eén onafhankelijke kostenmeting is ook niet het laatste woord. Artificial Analysis draait een vaste takenreeks; jouw repository is die reeks niet. De reden om de kosten-per-taakbenadering te vertrouwen is niet de specifieke $0,55 — het is dat de maatstaf de juiste is.
Een max-reasoning-configuratie in preview is normaal. Gefaseerd uitbrengen achter veiligheidstests is redelijke praktijk, en de ergernis hier is presentatie, geen ethiek: de cijfers stonden in materiaal gericht op mensen die ze nog niet kunnen krijgen.
Een versiesprong is geen migratie. 1.2 werkt nog, kost nog hetzelfde per token, en een productieagent overzetten naar een model dat op ander langlopend gedrag is afgestemd, verandert hoe je prompts zich gedragen op manieren die geen benchmark voorspelt.
Muse Spark 1.3 is een echte verbetering, uitgebracht tegen een ongewijzigde prijs per token, in een harness die mensen al draaien, met een venster van 1M waarvan de retrievalkwaliteit over het hele venster standhoudt. Dat is een goede release.
Hij komt ook met twee cijfers die tegengesteld wijzen — minder tokens per eenheid werk volgens de leverancier, hogere kosten per taak volgens een onafhankelijke partij — en met een scorekaart waarvan de helderste kolom een configuratie is die nog niemand kan kopen. Geen van beide is schandalig. Beide zijn gewoon, en beide bepalen precies of je inferentierekening in november overeenkomt met het plan dat je in september schreef.
Prijs per token vertelde je deze week niets. Kosten per afgeronde taak, op je eigen taken, wel.
Bronnen: Meta AI Research, "Introducing Muse Spark 1.3" · VentureBeat, "Meta says Muse Spark 1.3 has frontier performance — but its best results come from a model developers can't broadly use yet" · MarkTechPost, "Meta AI Released Muse Spark 1.3" · De efficiëntiecijfers van ~20%/~25% zijn van Meta zelf, uit evaluaties door Meta-engineers op langlopende codeertaken. Benchmarkscores, de $0,55 kosten per taak, de doorvoer van 235,2 tokens per seconde en de splitsing tussen Xhigh en max zijn zoals gerapporteerd door Artificial Analysis via VentureBeat; de max-configuratie zat ten tijde van de test in beperkte partnerpreview. Waar Terminal-Bench 2.1-cijfers per bron verschillen, staat dat in sectie 6. De lezing dat de twee kostenclaims verenigbaar zijn, en elke aanbeveling, zijn van mij. Voor de harness waarin dit model draait, zie de twee agent-harnesses die een dag na elkaar uitkwamen.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.