Meta dit que Muse Spark 1.3 consomme 25 % de tokens en moins. Les tests indépendants disent que votre facture a monté

By Surya Pratap
15 septembre 2026
12 min de lecture
IA et technologie

15 septembre 2026
12 min de lecture
 Deux versions du coût, une seule factureHover to explore
Meta a publié Muse Spark 1.3 le 2 septembre 2026, dans Muse Code et la Meta Model API. Le lancement comporte une histoire d'efficacité et une histoire de benchmarks, et chacune mérite deux lectures — non parce que l'une serait fausse, mais parce qu'aucune ne dit tout à fait ce qu'un fondateur supposerait.
Muse Spark 1.3, tel que publié
Disponible aujourd'hui ; les poids sont fermés
Deux de ces points sont de vraies bonnes nouvelles. La fenêtre de 1M est assez grande pour que « est-ce que ça rentre » cesse d'être la question quotidienne sur la plupart des bases de code, et maintenir le tarif par token à plat lors d'une montée en capacité est une concession réelle dans un marché qui, globalement, ne la fait pas.
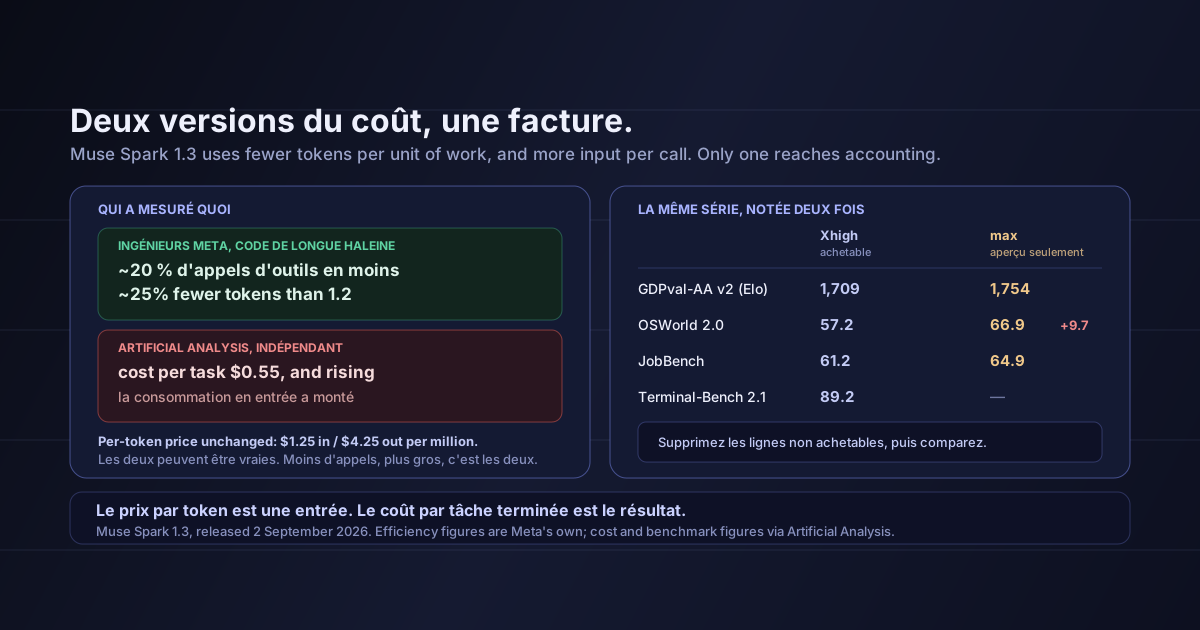
Le titre de Meta, c'est que 1.3 consomme ~20 % d'appels d'outils en moins et ~25 % de tokens en moins que Muse Spark 1.2.
La précision compte : ces chiffres proviennent d'évaluations menées par des ingénieurs de Meta sur des tâches de programmation de longue haleine. C'est une comparaison interne à l'éditeur, sur une charge de travail choisie par l'éditeur — ni inventée, ni auditée, ni nécessairement la vôtre.
Prise au mot, c'est aussi une affirmation plus étroite qu'il n'y paraît. Moins d'appels et moins de tokens par unité du travail qu'ils ont mesuré. Que votre facture baisse dépend d'une quantité que Meta n'a pas publiée : la quantité de contexte que porte chacun des appels restants.
Artificial Analysis, en test indépendant, a mesuré un coût par tâche de 0,55 dollar sur la configuration largement disponible — et rapporté des coûts par tâche en hausse par rapport à 1.2 malgré le tarif par token inchangé, parce que la consommation de tokens en entrée a augmenté.
Mettez les deux constats côte à côte : ils ne se contredisent pas. Ils décrivent deux moitiés du même changement.
Des appels moins nombreux et plus gros, c'est un gain d'efficacité selon une mesure et une hausse de coût selon l'autre. Un modèle qui réfléchit davantage à chaque étape fait moins d'étapes et lit plus à chacune.
C'est l'arithmétique de la taxe de contexte. Le travail agentique se facture sur ce que le modèle lit, pas sur le nombre de fois où il s'arrête pour réfléchir, et un harnais qui charge plus de contexte par appel pour justifier d'en faire moins peut consommer davantage au total pendant que chaque chiffre de titre s'améliore.
Le chiffre à réclamer dans toute annonce de modèle
Le prix par token est une entrée, pas un résultat. Le seul chiffre qui tranche une décision de bascule, c'est le coût par tâche terminée sur votre charge de travail : l'exécution entière, reprises, tentatives ratées et contexte porté par chaque appel compris. Meta a publié des ratios d'efficacité ; Artificial Analysis a publié un coût par tâche. Quand ces deux-là pointent en sens inverse, c'est le second qui arrive à la comptabilité.
C'est la partie que la plupart des reprises ont aplatie, et elle change la lecture du tableau.
Muse Spark 1.3 a été évalué dans deux configurations. L'une est achetable aujourd'hui. L'autre non.
L'écart n'est pas cosmétique. Sur OSWorld 2.0 il atteint 9,7 points — 57,2 contre 66,9 — et la configuration maximale figurait en bonne place dans les supports de lancement tout en étant impossible à acheter.
Personne ne trompe personne à proprement parler : les configurations sont étiquetées. Mais un fondateur qui parcourt un tableau comparatif lira le chiffre le plus élevé de la colonne Muse et le comparera à ce qu'il fait tourner aujourd'hui, et cette comparaison se trompe d'une dizaine de points sur le benchmark qui ressemble le plus au fait de piloter un ordinateur.
Règle pratique : dans tout lancement de modèle, trouvez la note qui précise sous quelle configuration chaque colonne a tourné, et supprimez toutes les lignes que vous ne pouvez pas acheter.
La ligne tarifaire qui mérite le plus de réflexion est celle qui ressemble à la meilleure affaire.
Le standard est à 1,25 / 4,25 dollar par million de tokens. Le palier contributor est à 0,10 / 0,20 — environ 12 fois moins cher en entrée et 21 fois en sortie — en échange de l'autorisation d'utiliser vos données pour l'entraînement.
Pour un projet parallèle sans produit, c'est de l'inférence quasi gratuite et un oui facile. Pour tout ce qui transporte des données clients, c'est une tout autre question, et ce n'est pas d'abord une question de coût :
Rien de tout cela ne rend le palier mauvais. Meta est inhabituellement explicite sur l'échange, davantage que la plupart des offres d'inférence à prix réduit. Cela signifie simplement que la décision revient à qui détient vos engagements sur les données, pas à qui surveille la facture d'inférence.
Trois éléments de contexte, tous nuancés.
Le débit est en retrait. À 235,2 tokens de sortie par seconde, Muse Spark 1.3 tourne environ 30 % plus lentement que Gemini 3.8 Flash. En programmation interactive cela se sent ; pour du traitement nocturne par lots c'est quasi indifférent.
Poids fermés, avec une feuille de route qui n'est pas un plan. Meta mentionne une publication de Muse Spark en poids ouverts parmi « des modèles plus grands… et plus » — sans version, sans date, sans conditions de licence. Si votre architecture suppose de finir par auto-héberger, cette phrase n'est pas un appui. Comparez avec les harnais sortis ouverts en août, où la portabilité était le produit et non une intention future.
L'éventail de benchmarks est vraiment solide là où il l'est. Terminal-Bench 2.1 à 89,2, DeepSearchQA à 89,4, récupération en contexte long à 98,5 pour 256K–512K et 98,1 pour 512K–1M. C'est ce dernier couple que je pondérerais le plus, car une qualité de récupération quasi plate sur une fenêtre de 1M est ce qui rend un grand contexte digne d'être payé plutôt que simplement grand.
Une réserve sur les chiffres : les valeurs publiées de Terminal-Bench 2.1 pour 1.3 varient légèrement selon la source — 89,2 dans le tableau d'Artificial Analysis et 88,8 ailleurs. C'est un écart d'arrondi sans effet sur aucune décision, mais quand les sources divergent la règle de la maison est de le dire.
Si vous faites tourner aujourd'hui une charge de programmation agentique, il s'agit d'une expérience de deux heures plutôt que d'un exercice de lecture.
Comment j'évaluerais réellement la mise à niveau
La comparaison doit porter sur la tâche terminée, pas sur le token
Les chiffres d'efficacité internes ne sont pas faux, ils sont étroits. « Des ingénieurs de Meta l'ont mesuré sur des tâches de longue haleine » est une méthodologie déclarée, et c'est déjà plus que bien des lancements. Cela reste leur charge de travail et leur harnais.
Une mesure de coût indépendante n'est pas non plus le dernier mot. Artificial Analysis exécute une série de tâches fixe ; votre dépôt n'est pas cette série. La raison de se fier au cadrage coût par tâche n'est pas les 0,55 dollar précis — c'est que la métrique est la bonne.
Une configuration de raisonnement maximal en aperçu, c'est normal. Une sortie par paliers derrière des tests de sécurité est une pratique raisonnable, et l'agacement ici est de présentation, pas d'éthique : les chiffres ont été montrés dans des supports destinés à des gens qui ne peuvent pas encore les obtenir.
Un changement de version n'est pas une migration. 1.2 fonctionne toujours, coûte toujours autant par token, et basculer un agent de production vers un modèle réglé sur d'autres comportements de longue haleine changera le comportement de vos prompts d'une manière qu'aucun benchmark ne prédit.
Muse Spark 1.3 est une vraie amélioration livrée à tarif par token inchangé, dans un harnais que des gens font déjà tourner, avec une fenêtre de 1M dont la qualité de récupération tient sur toute la fenêtre. C'est une bonne sortie.
Elle arrive aussi avec deux chiffres qui pointent en sens inverse — moins de tokens par unité de travail selon l'éditeur, coût par tâche plus élevé selon un tiers indépendant — et un tableau dont la colonne la plus brillante est une configuration que personne ne peut encore acheter. Rien de scandaleux là-dedans. Les deux sont ordinaires, et les deux décident précisément si votre facture d'inférence de novembre correspondra au plan écrit en septembre.
Le prix par token ne vous a rien appris cette semaine. Le coût par tâche terminée, sur vos propres tâches, l'aurait fait.
Sources : Meta AI Research, "Introducing Muse Spark 1.3" · VentureBeat, "Meta says Muse Spark 1.3 has frontier performance — but its best results come from a model developers can't broadly use yet" · MarkTechPost, "Meta AI Released Muse Spark 1.3" · Les chiffres d'efficacité de ~20 %/~25 % sont ceux de Meta, issus d'évaluations menées par ses ingénieurs sur des tâches de programmation de longue haleine. Les scores de benchmarks, le coût par tâche de 0,55 dollar, le débit de 235,2 tokens par seconde et la séparation entre Xhigh et max sont ceux publiés par Artificial Analysis via VentureBeat ; la configuration maximale était en aperçu limité aux partenaires au moment des tests. Là où les chiffres de Terminal-Bench 2.1 diffèrent selon les sources, c'est signalé en section 6. La lecture des deux affirmations de coût comme compatibles, ainsi que chaque recommandation, sont les miennes. Pour le harnais dans lequel ce modèle tourne, voyez les deux harnais d'agents sortis à un jour d'intervalle.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.