Meta dice que Muse Spark 1.3 usa un 25% menos de tokens. Las pruebas independientes dicen que su factura subió

By Surya Pratap
15 de septiembre de 2026
12 min de lectura
IA y tecnología

15 de septiembre de 2026
12 min de lectura
 Dos versiones del coste, una sola facturaHover to explore
Meta publicó Muse Spark 1.3 el 2 de septiembre de 2026, en Muse Code y en la Meta Model API. El lanzamiento trae una historia de eficiencia y una historia de benchmarks, y conviene leer las dos veces cada una: no porque alguna sea falsa, sino porque ninguna dice exactamente lo que un fundador supondría.
Muse Spark 1.3, tal como salió
Disponible hoy; los pesos están cerrados
Dos de esas cosas son buenas noticias de verdad. La ventana de 1M es lo bastante grande como para que «¿cabrá?» deje de ser la pregunta diaria en la mayoría de las bases de código, y mantener plano el precio por token en una subida de capacidad es una concesión real en un mercado que en general no la hace.
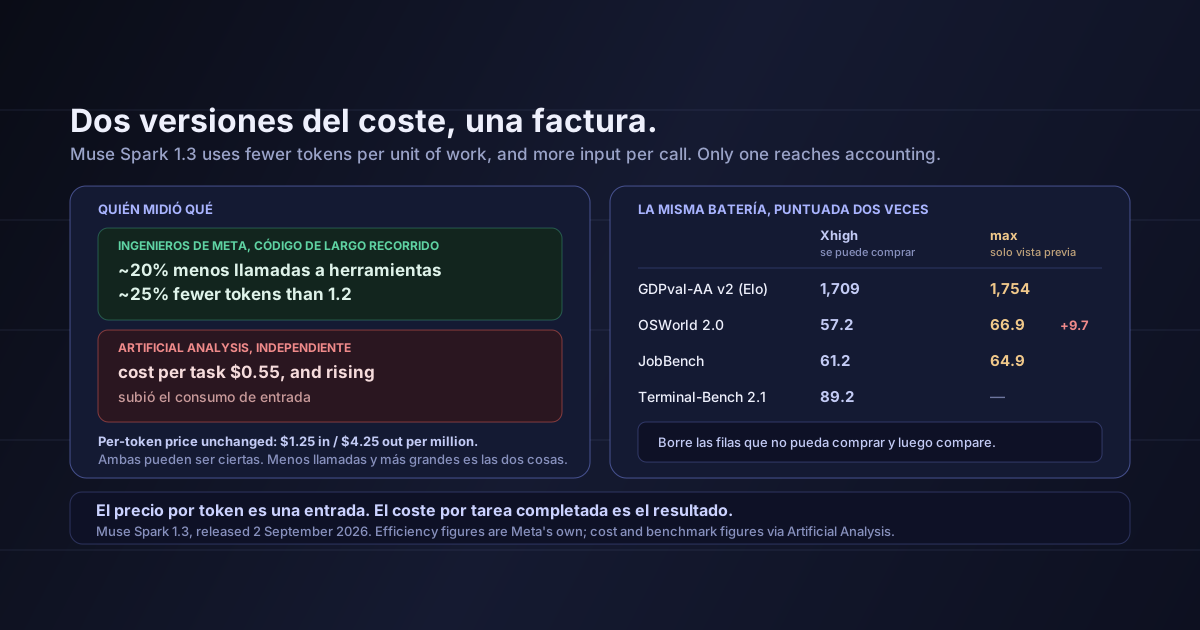
El titular de Meta es que 1.3 usa ~20% menos llamadas a herramientas y ~25% menos tokens que Muse Spark 1.2.
La precisión importa: esas cifras salen de evaluaciones de ingenieros de Meta sobre tareas de programación de largo recorrido. Es una comparación interna del proveedor sobre una carga de trabajo elegida por el proveedor: ni inventada, ni auditada, ni necesariamente la suya.
Leída al pie de la letra es además una afirmación más estrecha de lo que parece. Menos llamadas y menos tokens por unidad del trabajo que midieron. Que su factura baje depende de una cantidad que Meta no reportó: cuánto contexto lleva cada una de esas llamadas restantes.
Artificial Analysis, midiendo de forma independiente, situó el coste por tarea en 0,55 dólares en la configuración ampliamente disponible, e informó de costes por tarea al alza respecto a 1.2 pese al precio por token invariable, porque aumentó el consumo de tokens de entrada.
Ponga los dos hallazgos uno al lado del otro y no se contradicen. Describen mitades distintas del mismo cambio.
Menos llamadas y más grandes es una victoria de eficiencia con una métrica y una subida de coste con la otra. Un modelo que piensa más por paso da menos pasos y lee más en cada uno.
Es la misma aritmética que el impuesto de contexto. El trabajo con agentes se factura por lo que el modelo lee, no por cuántas veces se detiene a pensar, y un harness que carga más contexto por llamada para justificar hacer menos llamadas puede consumir más en total mientras mejora cada cifra del titular.
La cifra que hay que pedir en cualquier anuncio de modelo
El precio por token es una entrada, no un resultado. La única cifra que zanja una decisión de cambio es el coste por tarea completada sobre su carga de trabajo: la ejecución entera, incluidos los reintentos, los intentos fallidos y el contexto que llevaba cada llamada. Meta reportó ratios de eficiencia; Artificial Analysis reportó coste por tarea. Cuando esas dos apuntan en sentidos opuestos, la segunda es la que llega a contabilidad.
Esta es la parte que casi toda la cobertura aplanó, y cambia cómo debe leerse el marcador.
Muse Spark 1.3 se evaluó en dos configuraciones. Una se puede comprar hoy. La otra no.
La diferencia no es cosmética. En OSWorld 2.0 son 9,7 puntos —57,2 frente a 66,9— y la configuración máxima apareció de forma destacada en los materiales de lanzamiento pese a no poder comprarse.
Nadie engaña a nadie exactamente: las configuraciones están etiquetadas. Pero un fundador que hojea una tabla comparativa leerá la cifra más alta de la columna de Muse y la comparará con lo que tenga hoy en marcha, y esa comparación falla por unos diez puntos justo en el benchmark que más se parece a manejar un ordenador.
Regla práctica: en cualquier lanzamiento de modelo, busque la nota que dice bajo qué configuración se corrió cada columna y borre todas las filas que no pueda comprar.
La línea de precios que más merece pensarse es la que parece la mejor oferta.
El estándar es 1,25 / 4,25 dólares por millón de tokens. El nivel contributor es de 0,10 / 0,20 —unas 12 veces más barato en entrada y 21 veces en salida— a cambio de permitir que sus datos se usen para entrenar.
Para un proyecto paralelo sin producto, eso es inferencia casi gratis y un sí fácil. Para cualquier cosa que lleve datos de clientes es otra pregunta distinta, y no es sobre todo una pregunta de coste:
Nada de eso hace que el nivel esté mal. Meta es inusualmente explícita sobre el intercambio, más que la mayoría de las ofertas de inferencia con descuento. Solo significa que la decisión corresponde a quien sea dueño de sus compromisos sobre datos, no a quien vigila la factura de inferencia.
Tres apuntes de contexto, todos con matices.
El rendimiento va por detrás. Con 235,2 tokens de salida por segundo, Muse Spark 1.3 va alrededor de un 30% más lento que Gemini 3.8 Flash. En programación interactiva eso se nota; en trabajo por lotes nocturno es casi irrelevante.
Pesos cerrados, con una hoja de ruta que no es un plan. Meta menciona una publicación de Muse Spark con pesos abiertos entre «modelos más grandes… y más»: sin versión, sin fecha, sin condiciones de licencia. Si su arquitectura depende de acabar autoalojando, esa frase no es algo sobre lo que construir. Compare con los harnesses que salieron abiertos en agosto, donde la portabilidad era el producto y no una intención futura.
El abanico de benchmarks es realmente sólido donde lo es. Terminal-Bench 2.1 en 89,2, DeepSearchQA en 89,4, recuperación de contexto largo en 98,5 para 256K–512K y 98,1 para 512K–1M. Ese último par es el que yo más pesaría, porque una calidad de recuperación casi plana a lo largo de una ventana de 1M es lo que hace que un contexto grande merezca pagarse en lugar de ser solo grande.
Una salvedad sobre las cifras: los valores publicados de Terminal-Bench 2.1 para 1.3 varían ligeramente según la fuente: 89,2 en la tabla de Artificial Analysis y 88,8 en otros sitios. Es una diferencia de redondeo sin ninguna consecuencia para ninguna decisión, pero cuando las fuentes discrepan la norma de la casa es decirlo.
Si hoy ejecuta una carga de trabajo de programación con agentes, esto es un experimento de dos horas más que un ejercicio de lectura.
Cómo evaluaría yo la actualización de verdad
La comparación tiene que ser por tarea completada, no por token
Las cifras de eficiencia internas del proveedor no son falsas, son estrechas. «Ingenieros de Meta lo midieron sobre tareas de programación de largo recorrido» es una metodología declarada y más de lo que dan muchos lanzamientos. Sigue siendo su carga de trabajo y su harness.
Una sola medición independiente de coste tampoco es la última palabra. Artificial Analysis ejecuta una batería fija de tareas; su repositorio no es esa batería. La razón para fiarse del enfoque de coste por tarea no son los 0,55 dólares concretos: es que la métrica es la correcta.
Una configuración de razonamiento máximo en vista previa es normal. Publicar por fases tras pruebas de seguridad es una práctica razonable, y la molestia aquí es de presentación y no ética: las cifras se mostraron en materiales dirigidos a gente que todavía no puede obtenerlas.
Un salto de versión no es una migración. 1.2 sigue funcionando, sigue costando lo mismo por token, y cambiar un agente en producción a un modelo ajustado sobre otro comportamiento de largo recorrido alterará cómo se comportan sus prompts de maneras que ningún benchmark predice.
Muse Spark 1.3 es una mejora real, publicada sin subir el precio por token, dentro de un harness que la gente ya ejecuta, y con una ventana de 1M cuya calidad de recuperación aguanta a lo largo de toda la ventana. Es un buen lanzamiento.
También llega con dos cifras que apuntan en sentidos opuestos —menos tokens por unidad de trabajo según el proveedor, mayor coste por tarea según un tercero independiente— y con un marcador cuya columna más brillante es una configuración que nadie puede comprar todavía. Ninguna de las dos cosas es un escándalo. Las dos son corrientes, y las dos son exactamente lo que decide si su factura de inferencia de noviembre coincide con el plan que escribió en septiembre.
El precio por token no le dijo nada esta semana. El coste por tarea completada, sobre sus propias tareas, sí lo habría hecho.
Fuentes: Meta AI Research, "Introducing Muse Spark 1.3" · VentureBeat, "Meta says Muse Spark 1.3 has frontier performance — but its best results come from a model developers can't broadly use yet" · MarkTechPost, "Meta AI Released Muse Spark 1.3" · Las cifras de eficiencia de ~20%/~25% son de Meta, a partir de evaluaciones de ingenieros de Meta sobre tareas de programación de largo recorrido. Las puntuaciones de benchmarks, el coste por tarea de 0,55 dólares, el rendimiento de 235,2 tokens por segundo y la separación entre Xhigh y máximo son los publicados por Artificial Analysis vía VentureBeat; la configuración máxima estaba en vista previa limitada para socios en el momento de las pruebas. Cuando las cifras de Terminal-Bench 2.1 difieren entre fuentes se indica en la sección 6. La lectura de las dos afirmaciones de coste como compatibles, y todas las recomendaciones, son mías. Para el harness dentro del que corre este modelo, vea los dos harnesses de agentes que salieron con un día de diferencia.
IdeaToMVP Academy
4-week live cohort for founders. Learn to ship AI agents, scope MVPs, and automate your business — taught by the same team that writes these guides.